Archivierter Pilot · Veröffentlichte Läufe dieser Datenbank; Repo-Bundles und frühere Staging-Zählungen sind separate Bestände.
Archivierter Pilot · Läufe vom 17.07.2026 bis 01.10.2026
Prüfstand
Ein früher Pilot, heute Archiv. Wir haben Modellen einen Auftrag gegeben und zeigen, was sie daraus gebaut haben — als Screenshot, mit einfachen Prüfungen der Datei. Kein Funktionstest, keine Rangliste. Aktuelle Spitzenmodelle sind in diesem Pilot noch nicht vertreten.
- Läufe öffentlich
- 28
- Modelle · 6 Aufgaben
- 6
- mit Prüfung des Ergebnisses
- 6/28
- Bewertungen veröffentlicht
- 0/28
Was getestet wurde
Keines der aktuellen Spitzenmodelle von OpenAI, Anthropic, Google und SpaceXAI ist dabei.
Spitzenmodelle: was diese Anbieter selbst als ihre besten Modelle führen; Quellen gelesen am 04.10.2026.
28 veröffentlichte Läufe von 6 Modellen zu 6 Aufgaben. Laufdatum in UTC.
| Modell | Läufe | Aufgaben | Laufdatum | Aktuelles Spitzenmodell |
|---|---|---|---|---|
| Claude Haiku 4.5 | 4 | 4 | 17.07.2026 | nein |
| GPT-5.6 Sol | 4 | 4 | 17.07.2026 | nein |
| Claude Fable 5 | 6 | 6 | 18.07.2026 | nein |
| GPT-5.6 Luna | 6 | 6 | 18.07.2026 | nein |
| Phi-4-mini-instruct | 3 | 2 | 30.08.2026, 01.10.2026 | nein |
| Qwen3.8-27B | 5 | 5 | 03.09.2026 | nein |
Gefüllter Punkt: Lauf mit mindestens einer Prüfung des Ergebnisses. Leerer Punkt: Lauf ohne.
Datenviz-Dashboard mit Insights
frontend-dashboard-002-aA · Claude Fable 5 · Modell + HarnessB · Claude Haiku 4.5 · Modell + Harness
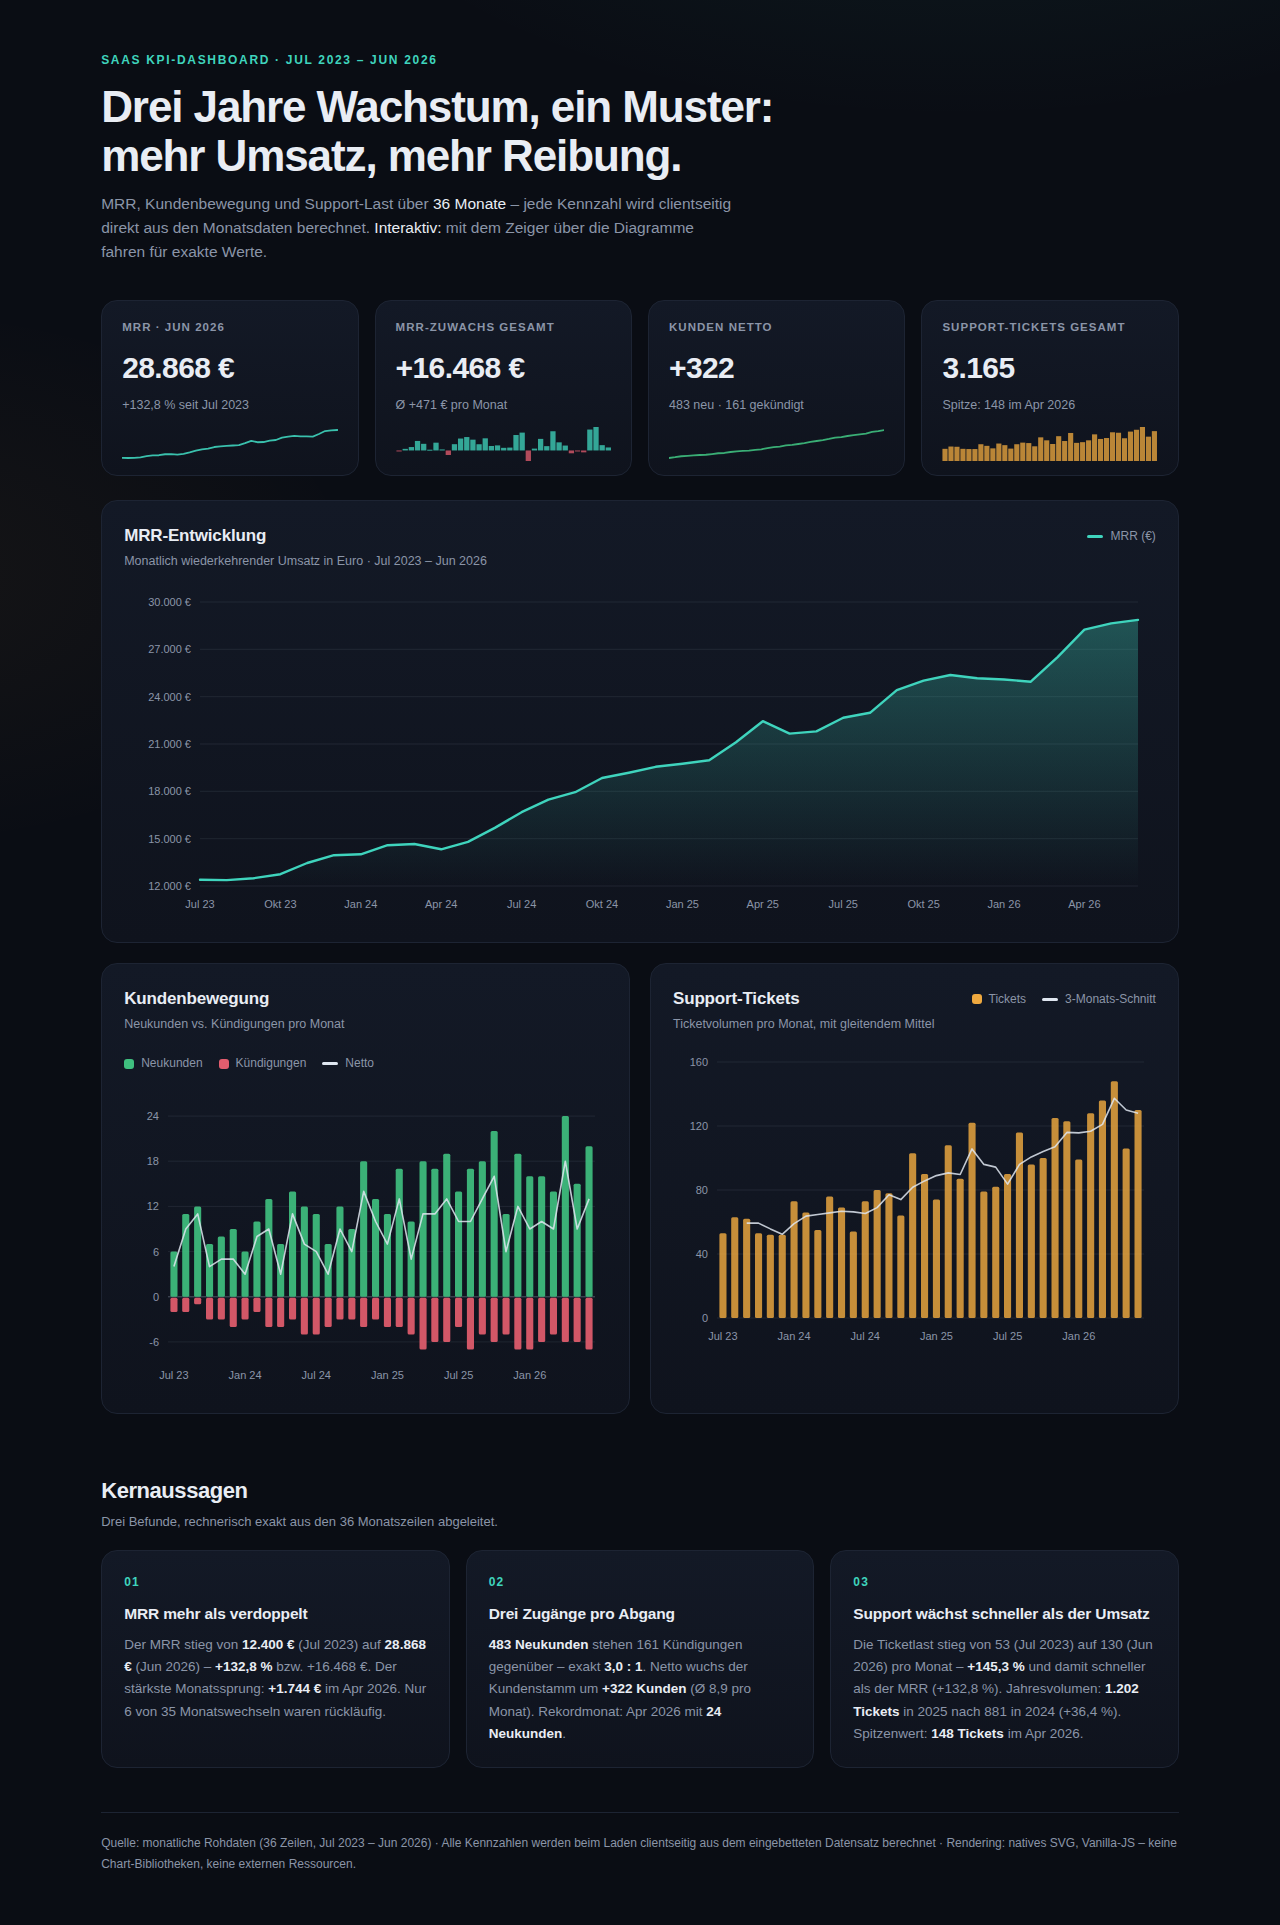
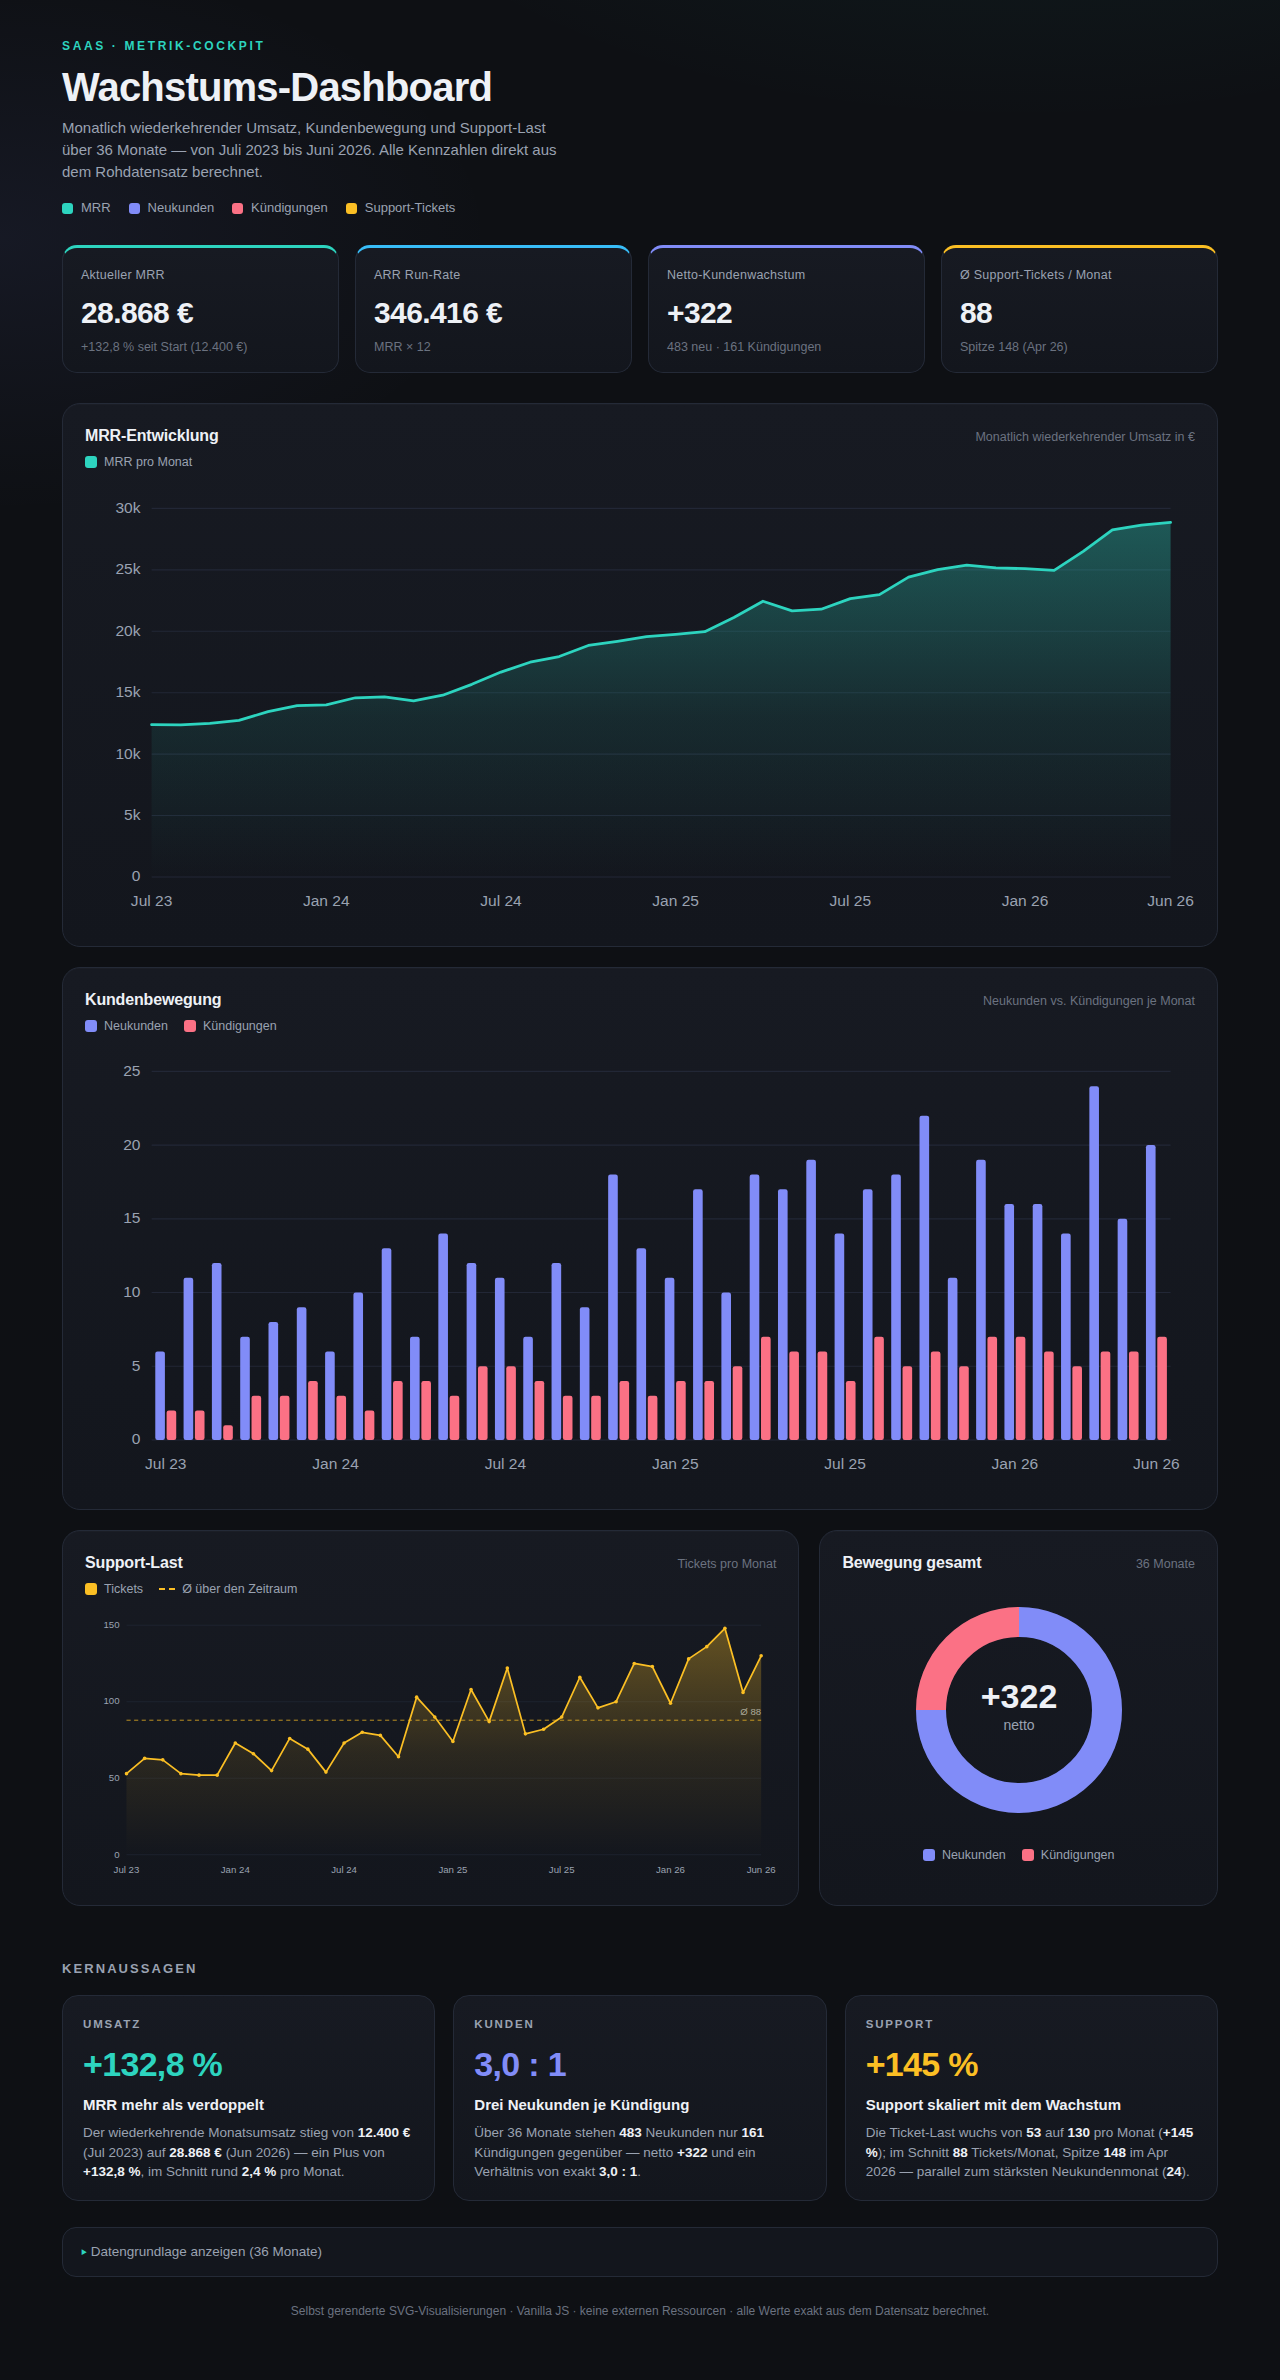 A · Claude Fable 5 · Modell + HarnessB · Claude Haiku 4.5 · Modell + Harness
Screenshots: Wir rendern die gespeicherte, vom Modell erzeugte Datei offline. Die Datei selbst wird nicht ausgeliefert. Der Vergleich zeigt den oberen Ausschnitt eines Standbilds je Lauf.
Alle Ergebnisse · Datenviz-Dashboard mit Insights
5 Läufe von 5 Modellen zum selben Auftrag. A und B holen einen Screenshot in den Vergleich. Läufe vom 17.07.2026 bis 03.09.2026.
Prüfergebnisse zurückgezogen (04.10.2026)Diese Prüfergebnisse passen nicht zu den Screenshots derselben Läufe. Deshalb ziehen wir die Ergebnisse zurück, bis die Prüfung im Browser wiederholt wurde. Betroffen: three_distinct_visualizations, five_aggregate_matches, three_numeric_insights.
Wir zeigen 5 von 16 verifizierten Läufen dieser Aufgabe — von 5 der 6 getesteten Modelle.Nicht veröffentlicht: Phi-4-mini-instruct (1 Lauf; Prüfergebnisse zurückgezogen).Quelle: die Auswahl-Angaben der veröffentlichten Läufe. Sie zählen die Aufgabe über alle Varianten und kennen nur Modelle, von denen mindestens ein Lauf veröffentlicht ist.
- Claude Fable 5Claude Fable 5zurückgezogen · Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenclaude-code-cli · Modell + Harness18.07.2026Lauf öffnen →
- Claude Haiku 4.5Claude Haiku 4.5zurückgezogen · Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenclaude-code-cli · Modell + Harness17.07.2026Lauf öffnen →
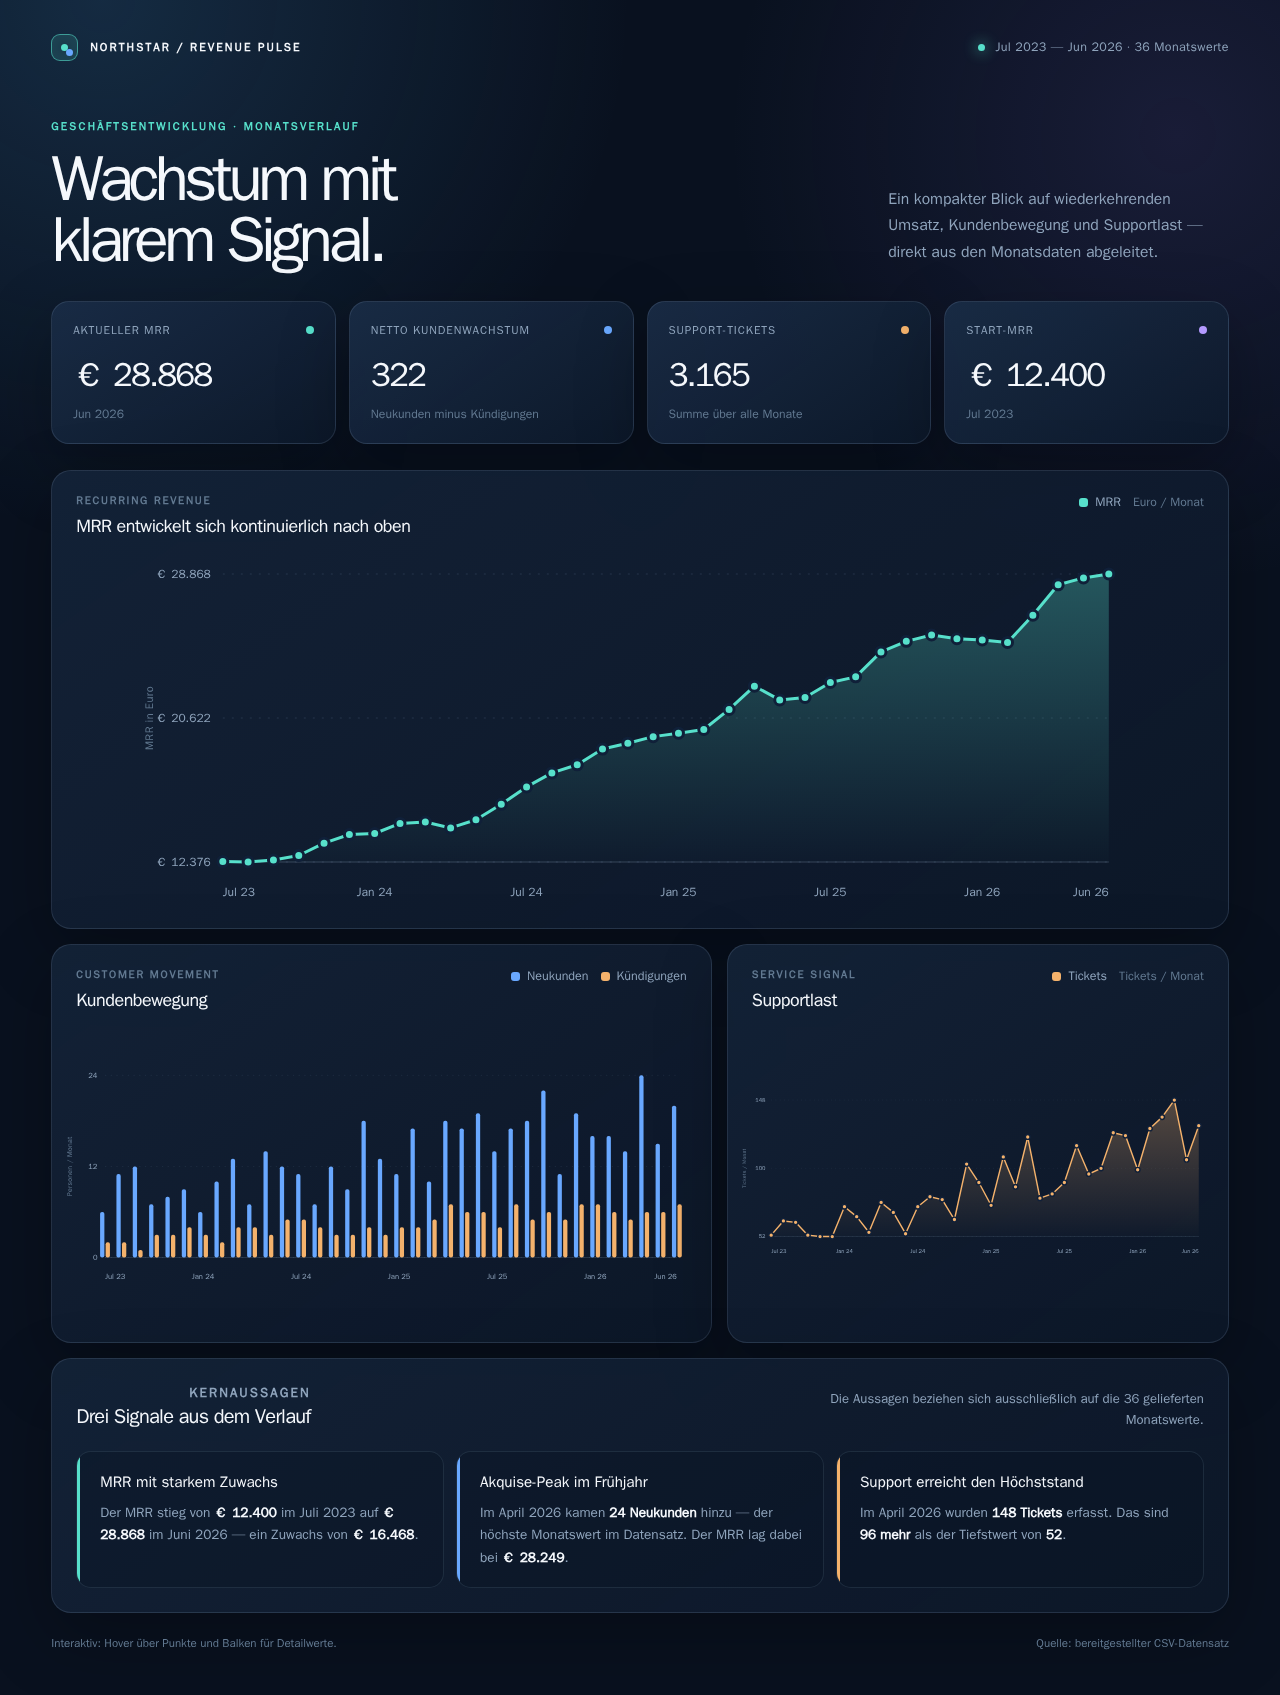 GPT-5.6 LunaGPT-5.6 Lunazurückgezogen · Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufencodex-cli · Modell + Harness18.07.2026Lauf öffnen →
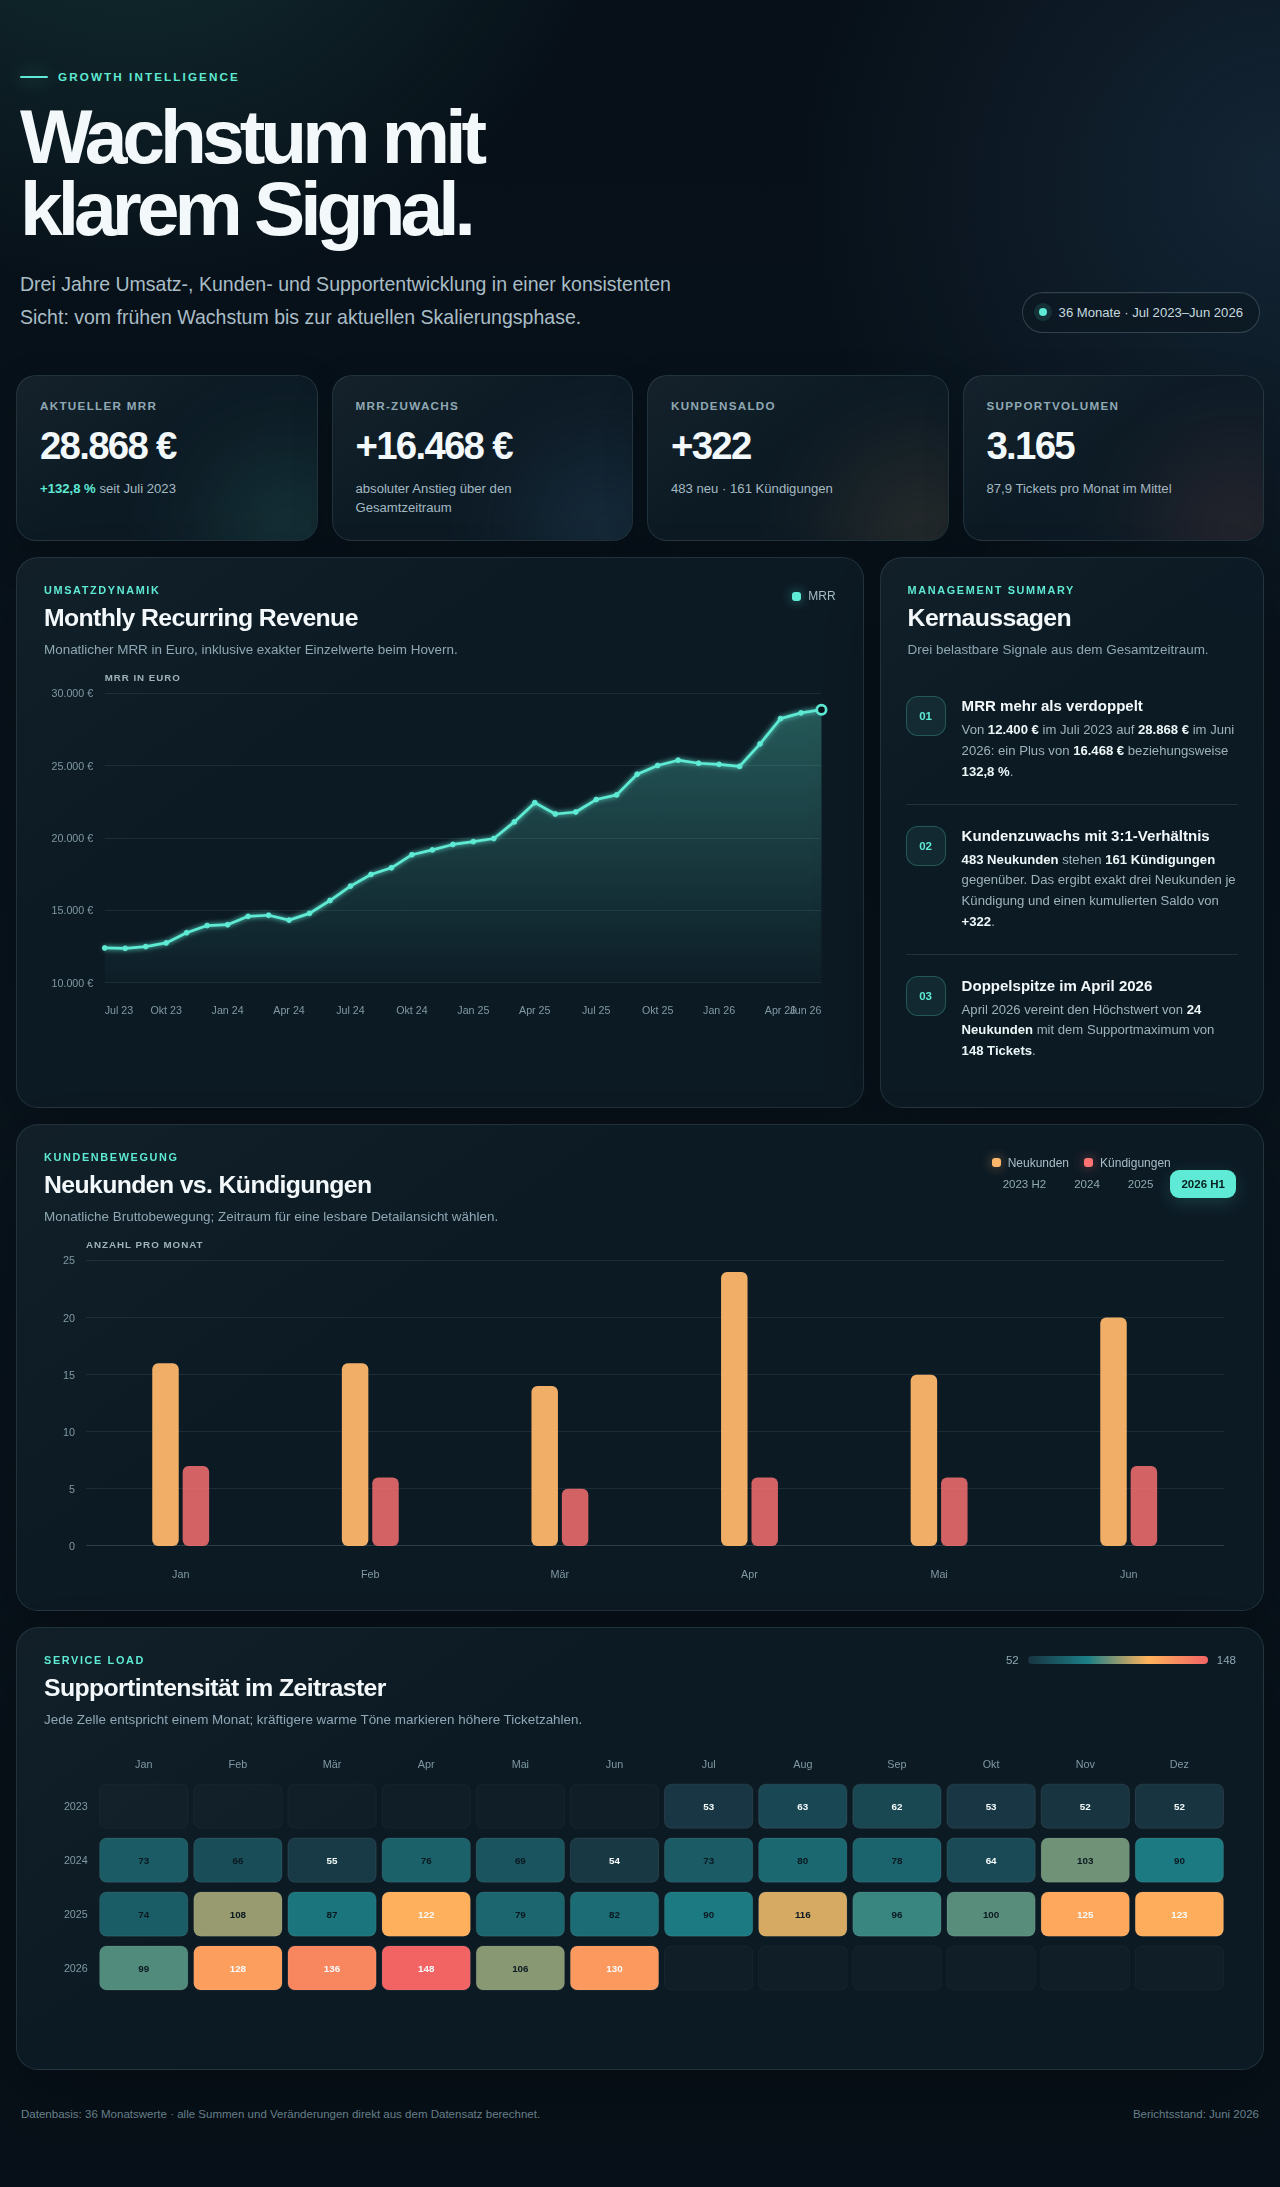 GPT-5.6 SolGPT-5.6 Solzurückgezogen · Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufencodex-cli · Modell + Harness17.07.2026Lauf öffnen →
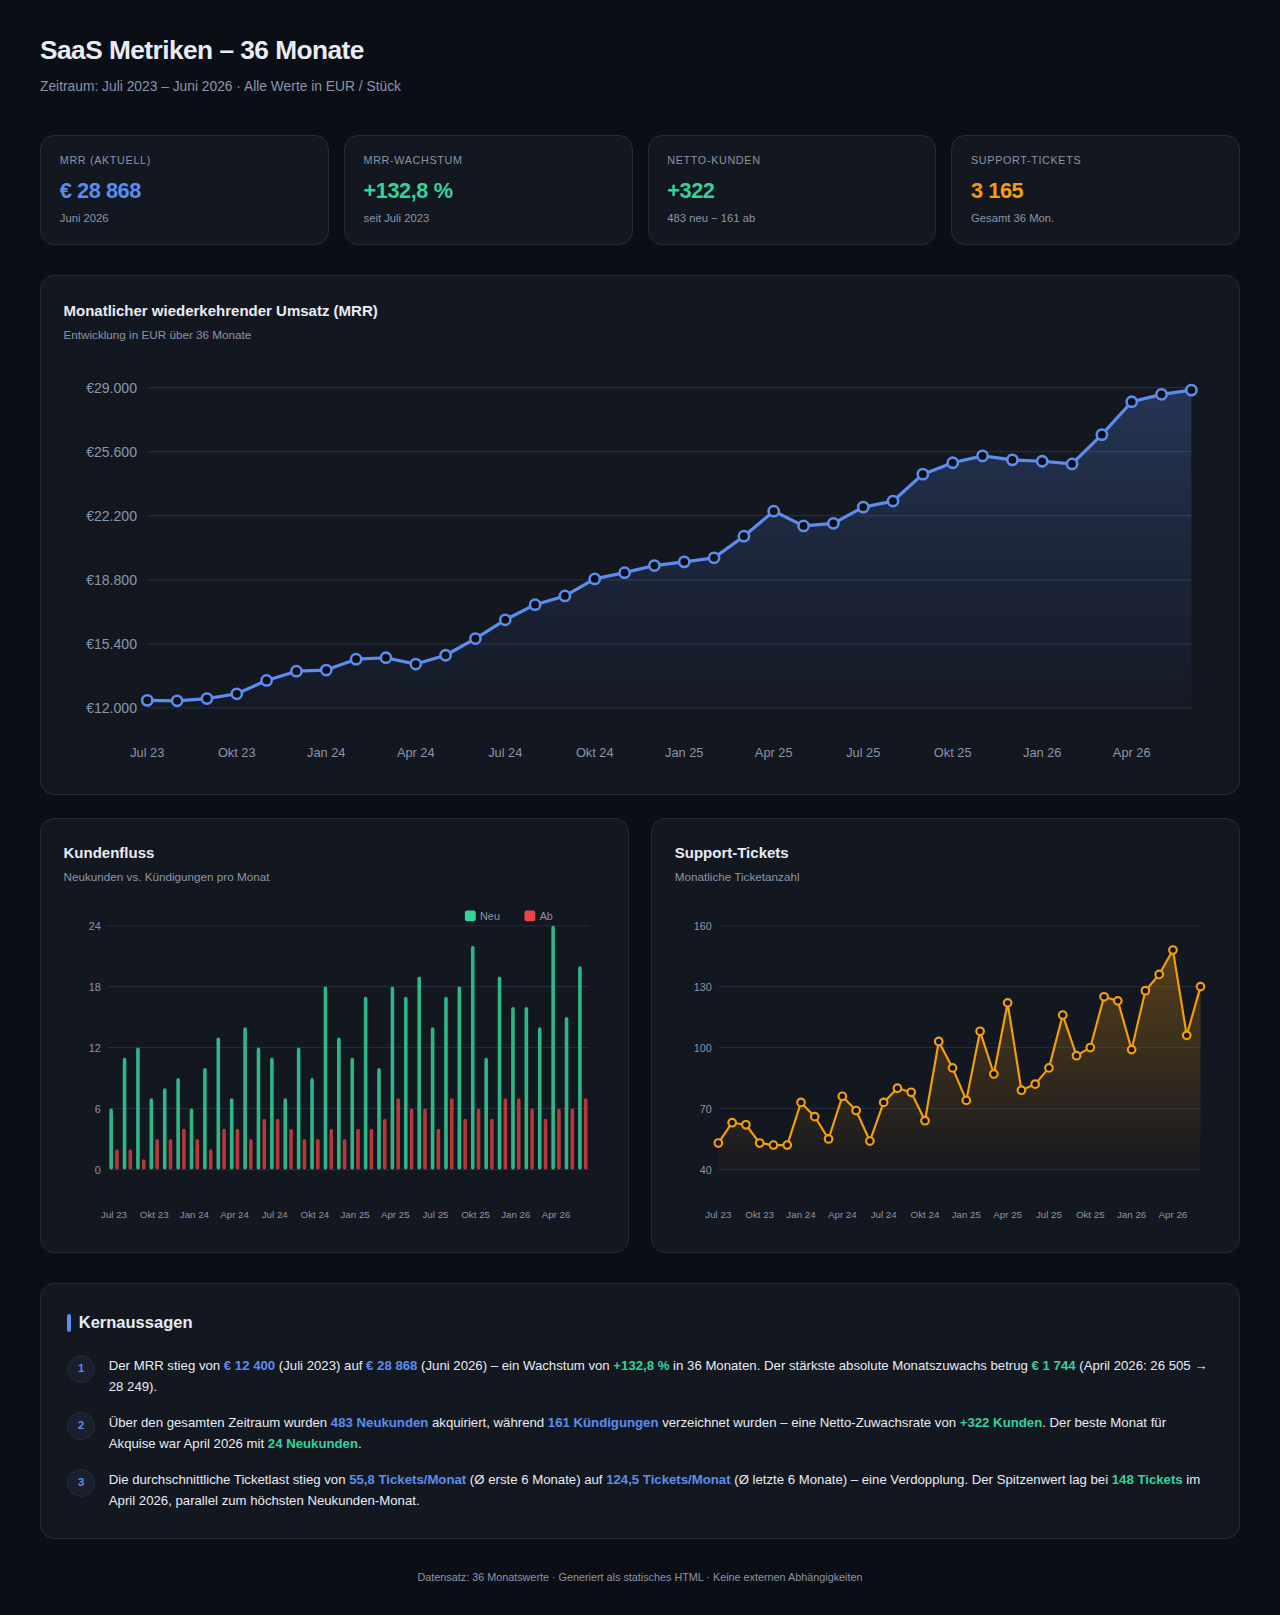 Qwen3.8-27BQwen3.8-27Bzurückgezogen · Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenollama · nur Modell03.09.2026Lauf öffnen →
Läufe derselben Aufgabe sind nicht automatisch gleich getestet: Laufzeit, Token-Limit und Protokoll können sich unterscheiden. Jeder Lauf nennt seine eigenen.