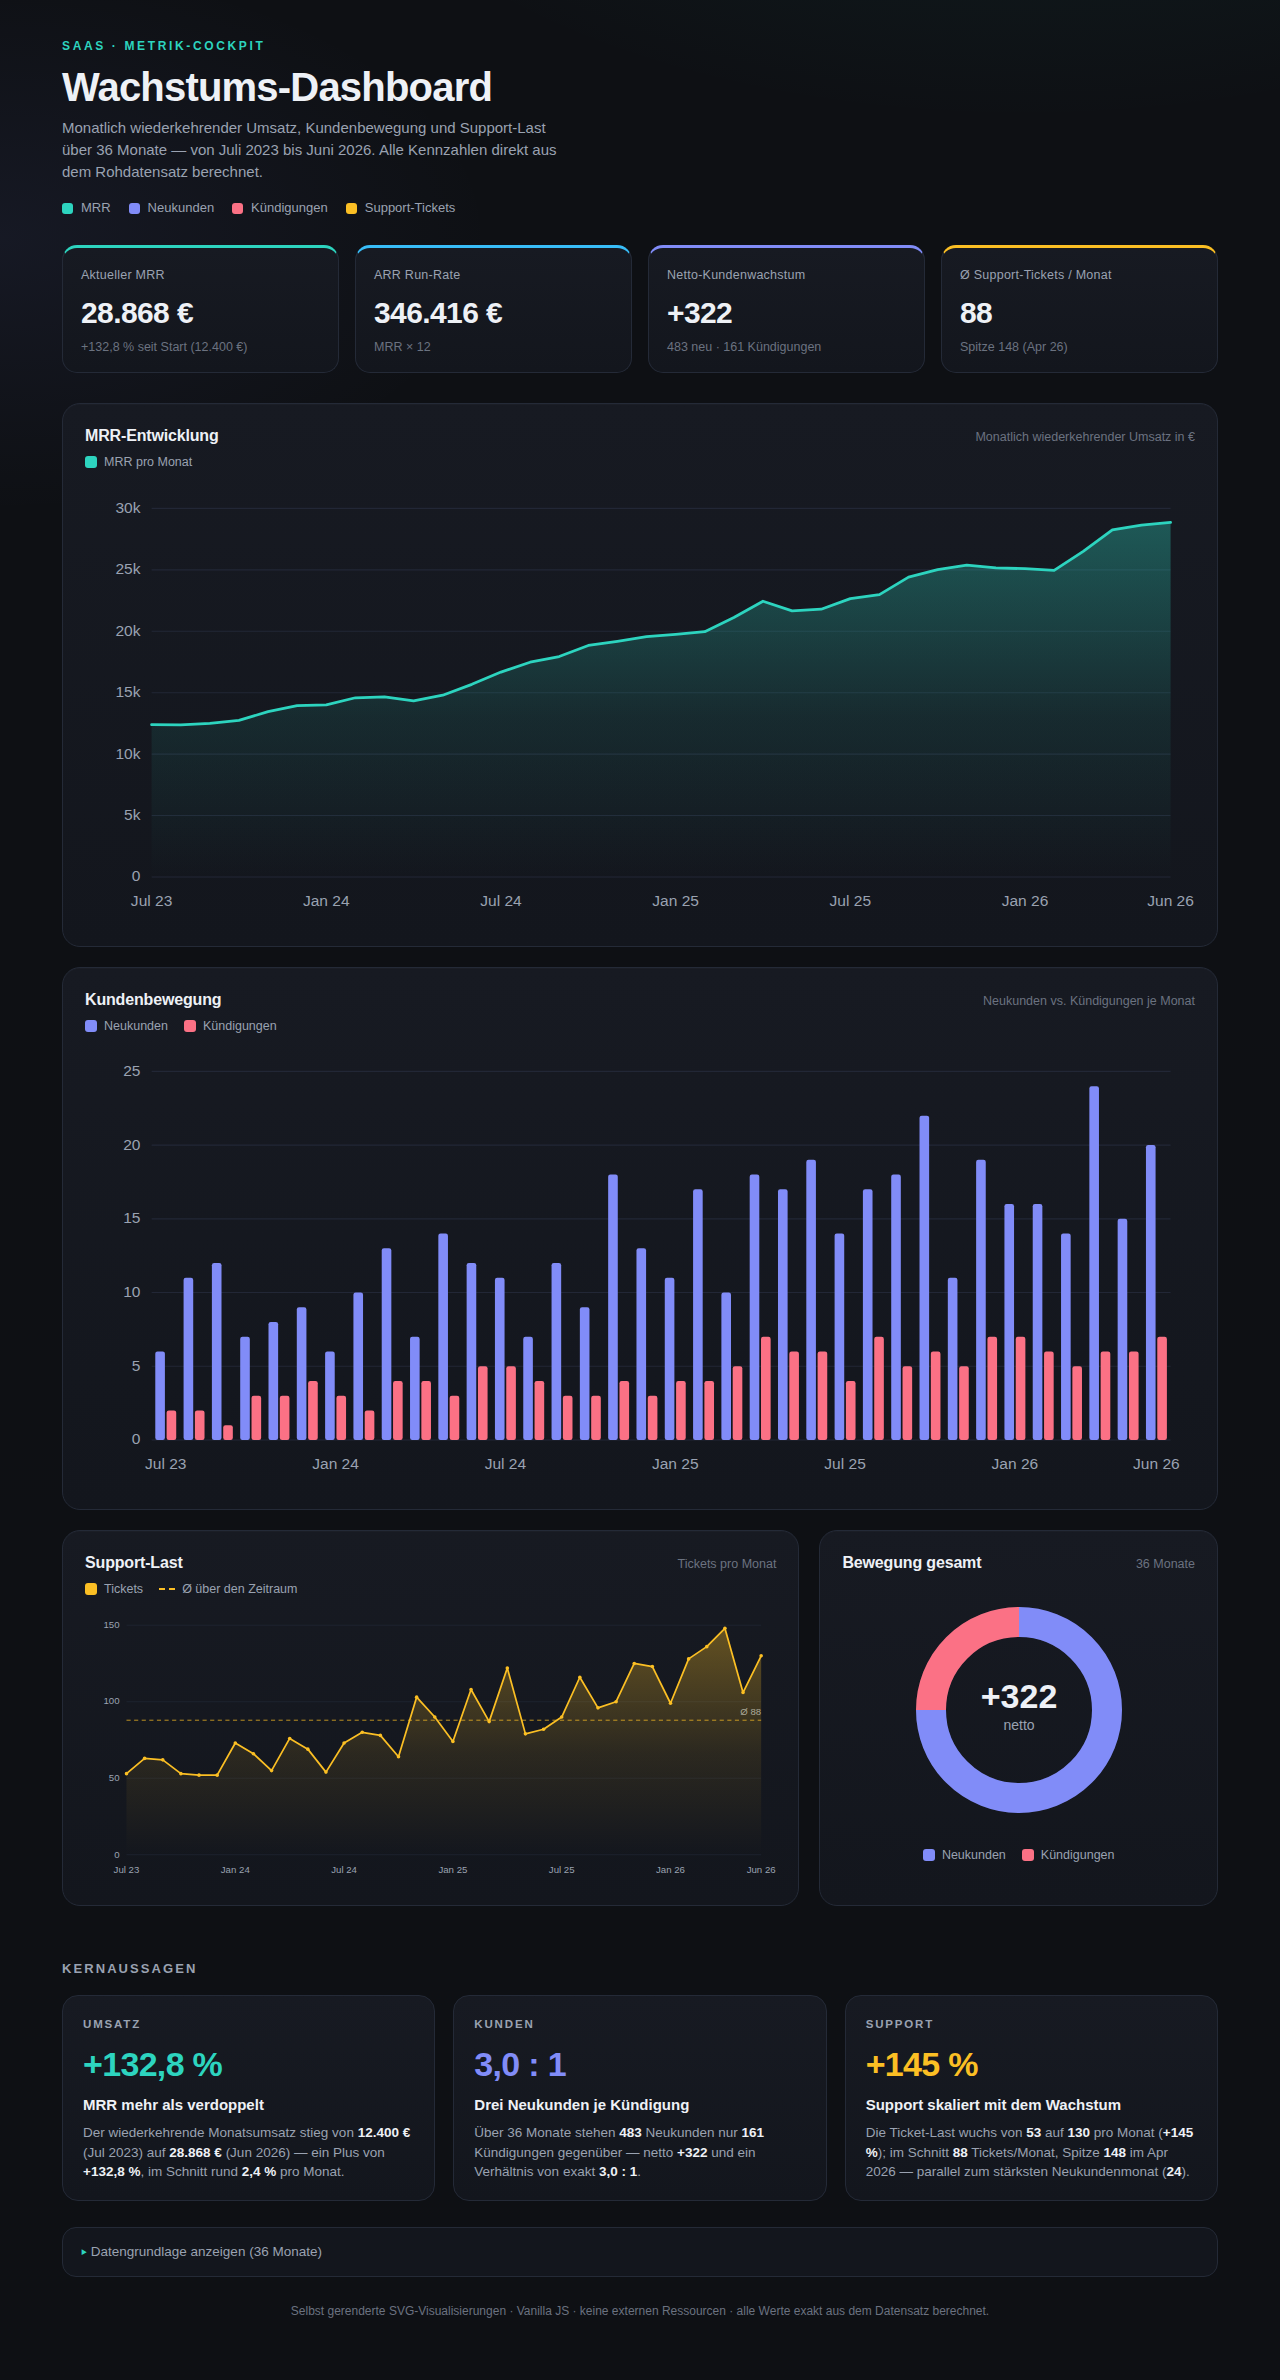
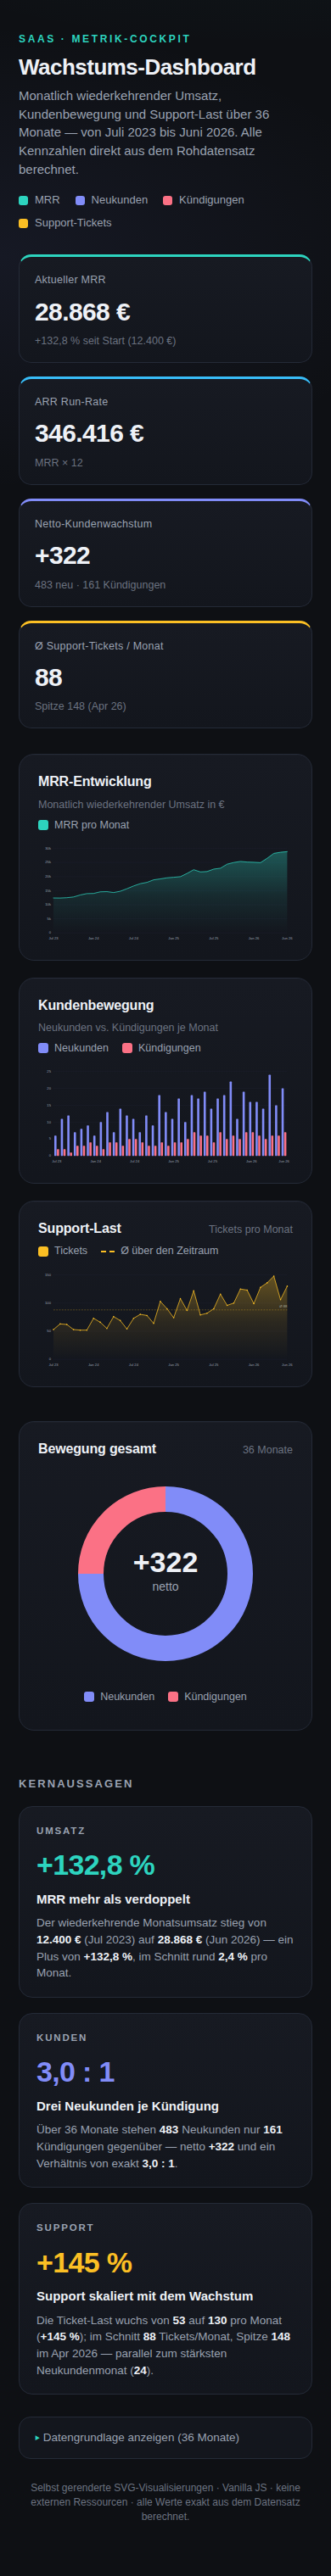
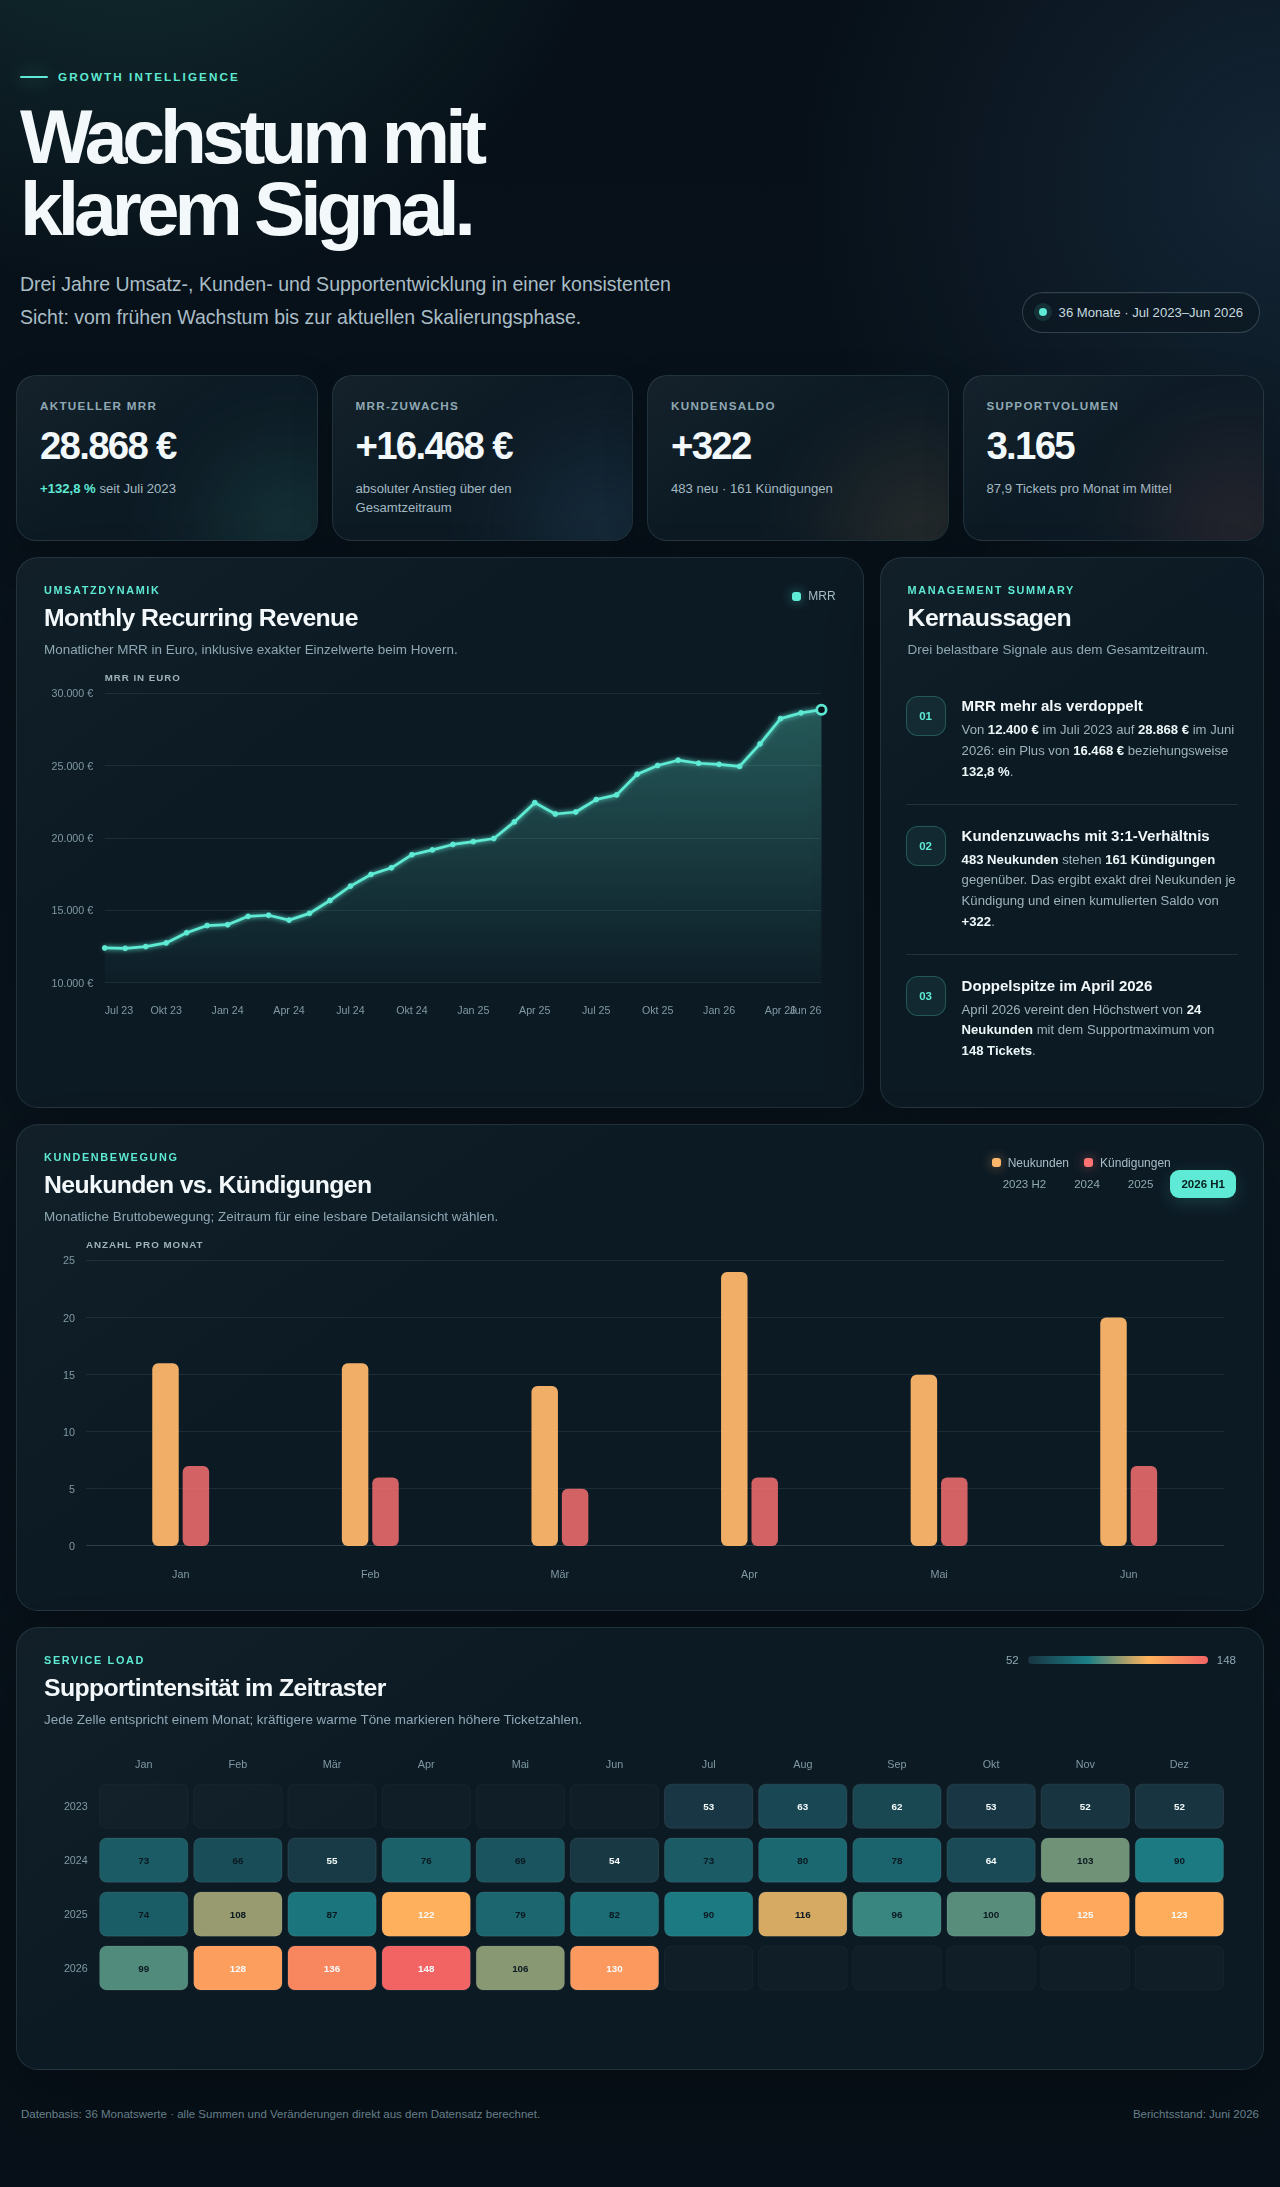
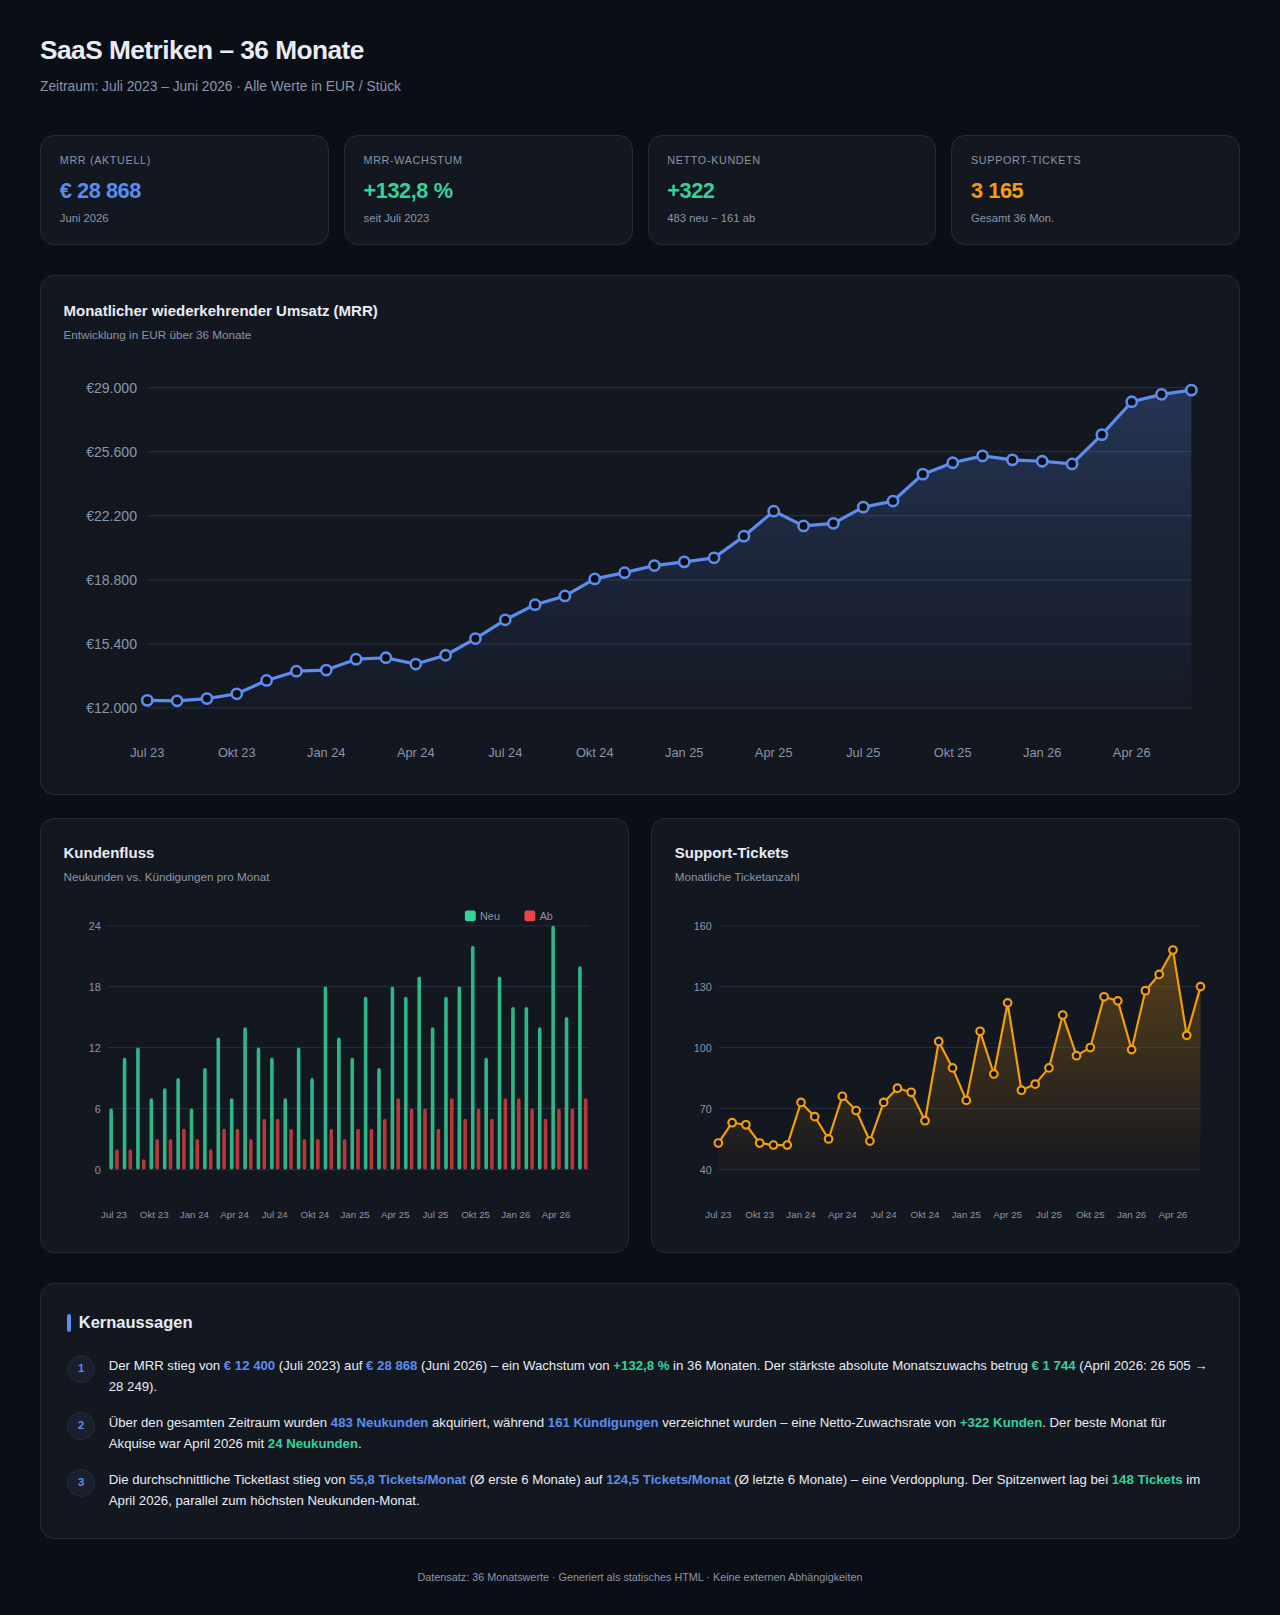
gebaut von Claude Haiku 4.5 über claude-code-cli 2.1.212Modell + Harness
Automatische Prüfungen
Prüfergebnisse zurückgezogen (04.10.2026)Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft2 Prüfungen im Browser nicht gelaufen
Bewertungsmodell
Bewertung nicht veröffentlicht
Gestartet
Dauer
468 s
Prüfergebnisse zurückgezogen (04.10.2026)Diese Prüfergebnisse passen nicht zu den Screenshots derselben Läufe. Deshalb ziehen wir die Ergebnisse zurück, bis die Prüfung im Browser wiederholt wurde. Betroffen: three_distinct_visualizations, five_aggregate_matches, three_numeric_insights.
Artefakt
Von agi.jetzt aus dem vom Modell erzeugten Artefakt gerendertOffline in einem isolierten Renderer aus der gespeicherten Datei gerendert (sha256 78782b901dde…). Die Datei selbst wird nicht ausgeliefert.
Desktop · 1280 pxMobil · 390 px
Gleicher Auftrag, andere Modelle
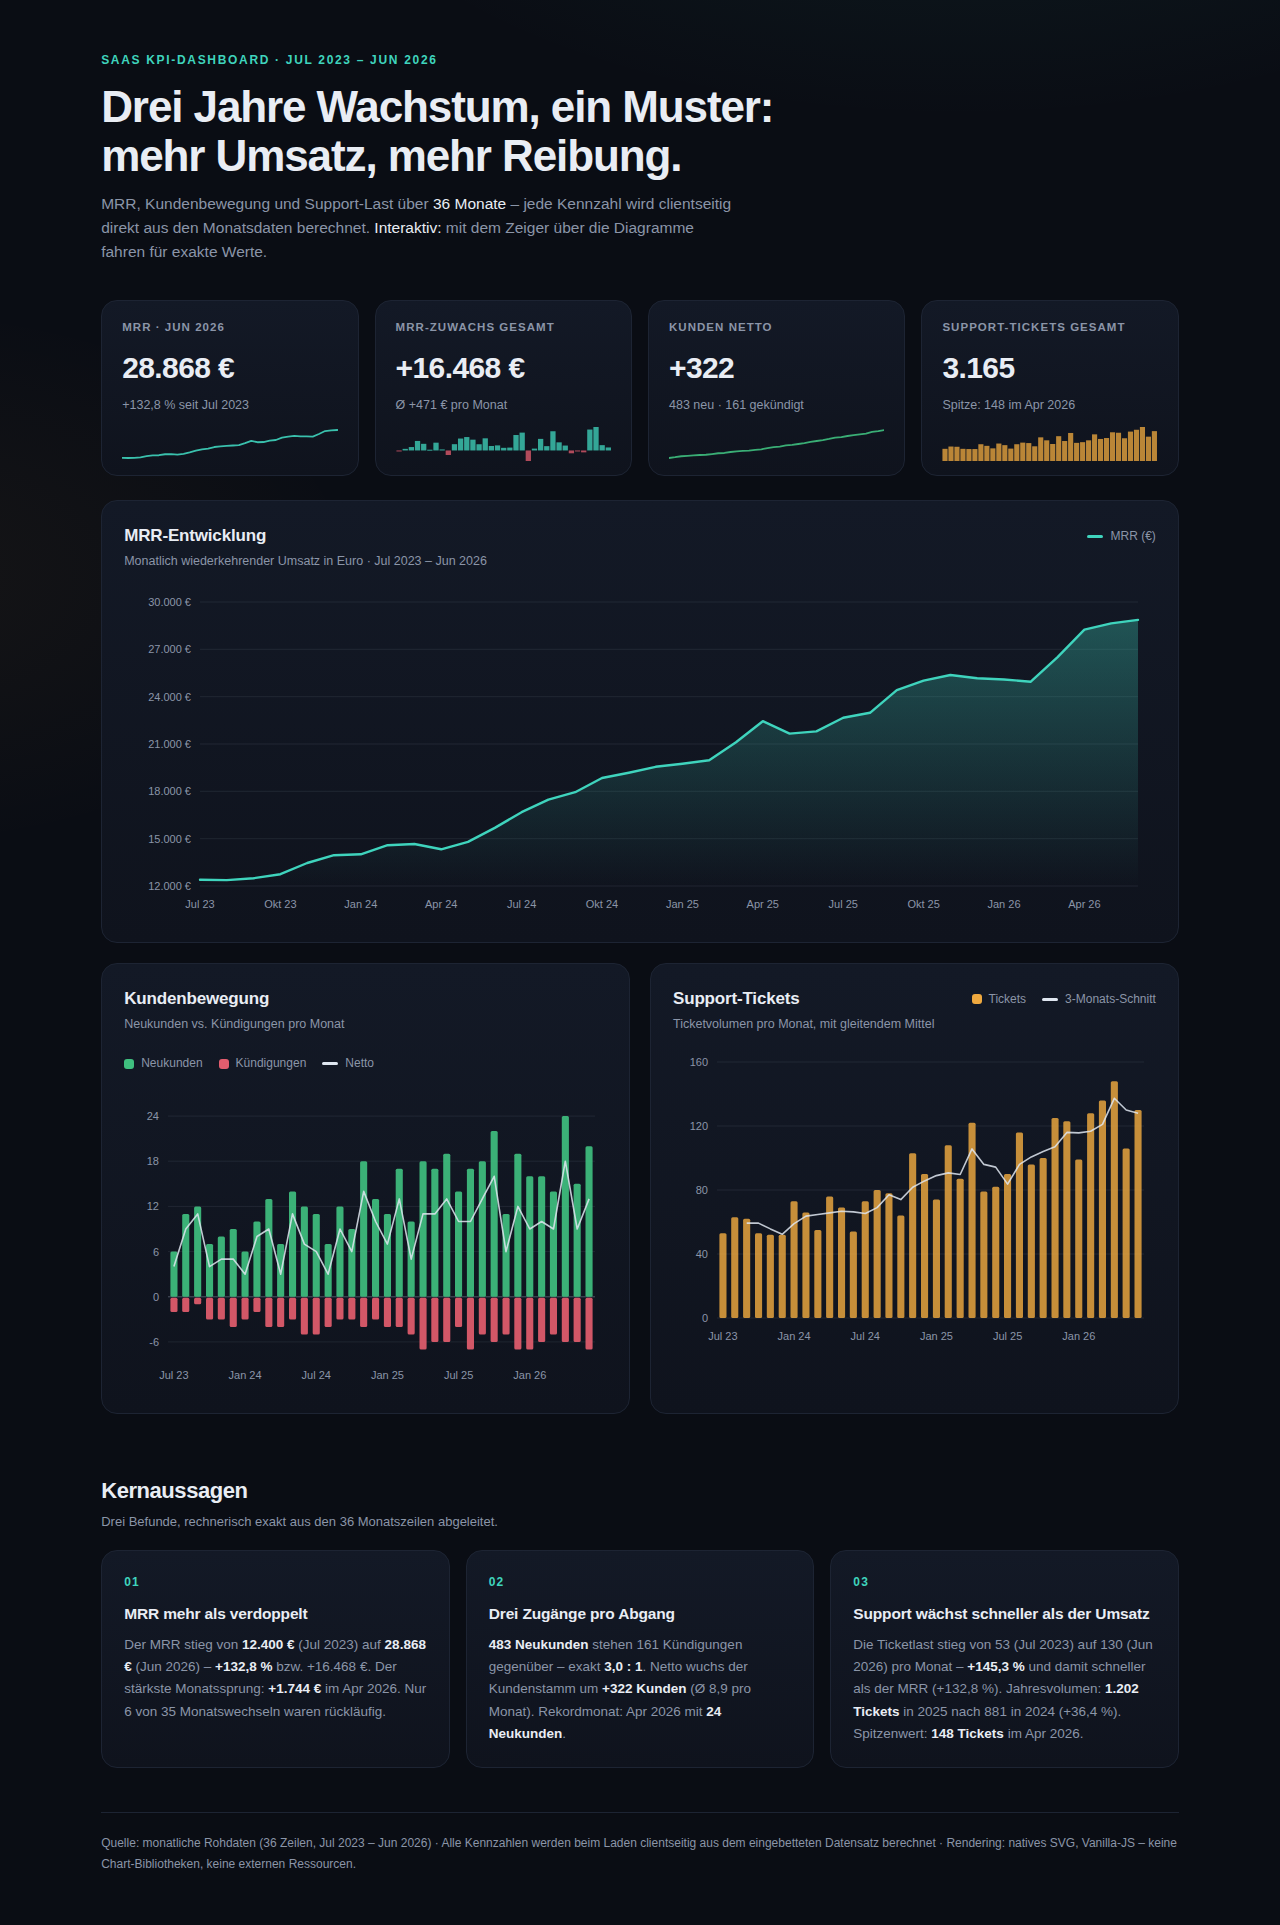
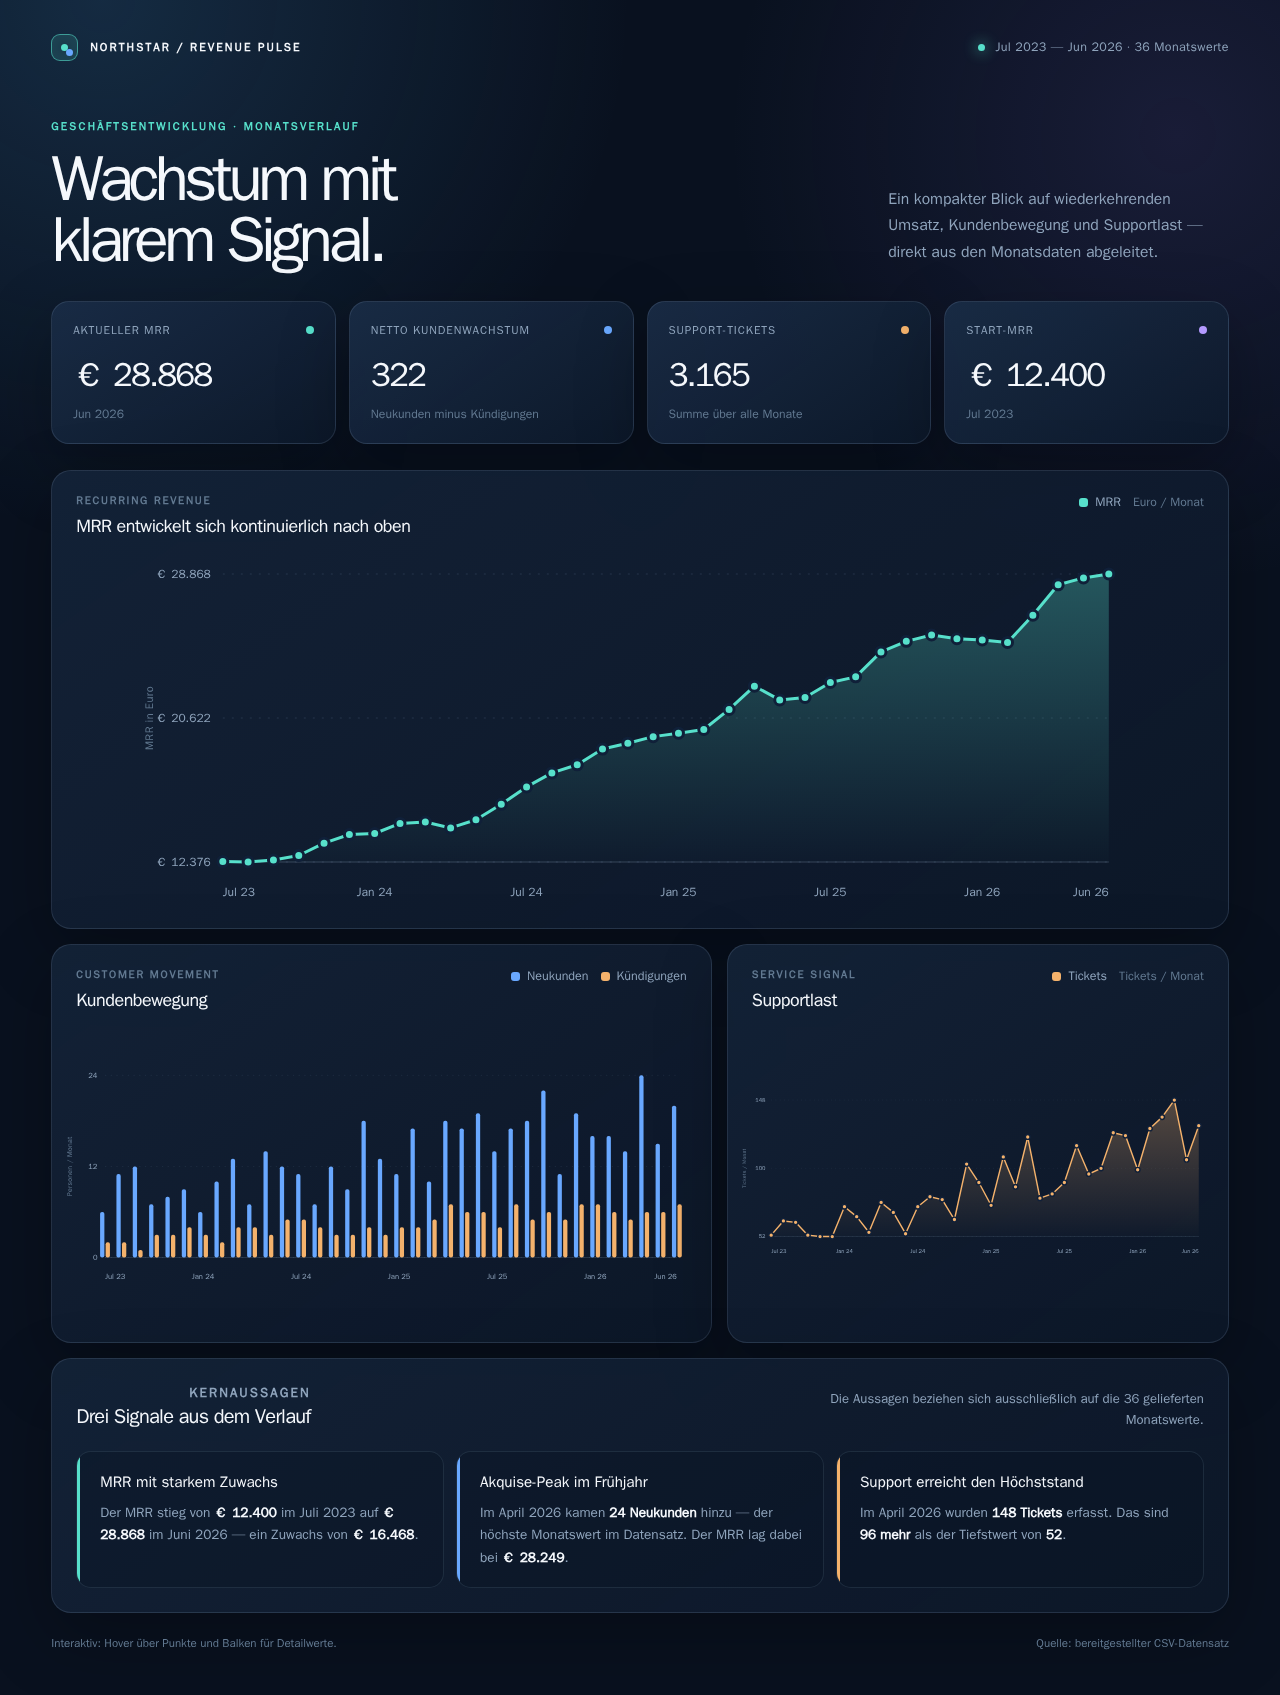
Seitlich scrollen. Jeder Lauf hatte eigene Laufzeit und Limits — vergleichen Sie die Artefakte, nicht einen Score.
Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
Automatische Prüfungen
Automatische Prüfungen an der gespeicherten HTML-Datei, ohne sie im Browser auszuführen. Prüfungen von Format und Vorhandensein sagen nichts darüber, ob das Ergebnis den Auftrag erfüllt.
Prüfung
Art
Ergebnis
single_html_filegenau eine HTML5-Datei
Format
Bestanden
three_distinct_visualizationsErgebnis am 04.10.2026 zurückgezogen; es wird kein Wert gezeigt.
Inhalt
zurückgezogen
five_aggregate_matchesErgebnis am 04.10.2026 zurückgezogen; es wird kein Wert gezeigt.
Zahlenwerte
zurückgezogen
three_numeric_insightsErgebnis am 04.10.2026 zurückgezogen; es wird kein Wert gezeigt.
Inhalt
zurückgezogen
renders_without_errorsSandbox nicht verfügbar — Rendering übersprungen
Rendering
nicht ausgeführt
no_external_librariesSandbox nicht verfügbar — Rendering übersprungen
Rendering
nicht ausgeführt
2 Prüfungen im Browser sind nicht gelaufen. Grund laut Protokoll: „Sandbox nicht verfügbar — Rendering übersprungen“.
Bewertung
Deterministischer Wert
Keine Note — Prüfergebnisse zurückgezogen
Bewertungsmodell
für diesen Lauf nicht veröffentlicht
WarumDer v2-Eintrag des Bewertungsmodells nennt das getestete Modell als sein eigenes Bewertungsmodell und enthält keine Kriterien. Sein Wert wird deshalb nicht gezeigt — ebenso wenig der kombinierte v2-Wert, in den er einfließt.
Grenzen dieses Laufs
2 Prüfungen im Browser sind nicht gelaufen. Ob das Ergebnis im Browser funktioniert, wurde nicht automatisch geprüft.
Keine ausgeführte Prüfung mit gezeigtem Ergebnis bewertet, was gebaut wurde.
Für diesen Lauf ist keine Bewertung veröffentlicht. Es gibt deshalb kein Qualitätsurteil — nur die hier aufgeführten automatischen Prüfungen.
Diese Einstellungen waren vorgesehen, wurden aber nicht erzwungen: Die Laufzeit wurde ohne sie aufgerufen.
Nicht vollständig reproduzierbar; der erfasste Grund steht unter „Umgebung“.
Aufgabe
Brief (Runde 1)
Unten steht ein CSV-Datensatz (ca. 40 Zeilen). Baue daraus eine einzelne HTML-Datei als beeindruckendes, interaktives Dashboard.
Anforderungen:
- Mindestens 3 Visualisierungen, selbst gerendert als SVG oder Canvas — keine Chart-Libraries, keine externen Assets, keine externen Requests.
- Interaktivität mit Vanilla-JS: beim Hovern über Datenpunkte/Balken/Segmente erscheinen präzise Tooltips mit dem konkreten Wert; Achsen und Legenden sind lesbar beschriftet.
- Eine Sektion „Kernaussagen" mit 3 datengestützten Insights; jeder Insight nennt mindestens eine konkrete Zahl aus den Daten.
- Alle gezeigten Zahlen müssen rechnerisch exakt aus dem Datensatz folgen.
- Gestaltung auf Studio-Niveau: klare Hierarchie, stimmige Farbwelt, ruhige Typografie, sinnvoll gewählte Diagrammtypen für die jeweilige Kennzahl. Responsive, kein horizontaler Overflow.
Datensatz:
[CSV, 36 Datenzeilen: Monats-KPIs eines B2B-SaaS (Juli 2023 bis Juni 2026): MRR, Neukunden, Kuendigungen, Support-Tickets.]
Aus dem Aufgaben-Seed; die tatsächlichen Prompts ergänzen Ausgabeformat-Anweisungen und andere Formulierungen.
Umgebung
Laufzeit
claude-code-cli 2.1.212
Ausführung
Modell + HarnessDas Modell lief in einem Agenten-Harness. Das Ergebnis beschreibt Modell + Harness, nicht das Modell allein.
Modell Die Modellkennung des Testprogramms entspricht Claude Haiku 4.5 in unserer Modellliste (verifizierte Zuordnung).
Was dieser Lauf zeigt — und was nicht
Kein AGI-MaßDieser Lauf zeigt genau eines: was ein Modell aus einem präzisen Brief als einzelne HTML-Datei gebaut hat. Über allgemeine Intelligenz sagt er nichts.In diesem Lauf automatisch geprüft: Prüfergebnisse zurückgezogen (04.10.2026) · Format stimmt (1 von 1) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufen.
Was der Aufgabensatz messen soll
Artefakt-Erstellung nach präzisem Brief
Befolgen von Anweisungen
Statische Prüfungen der Datei (kein Funktionstest)
Nicht sein Gegenstand
Allgemeine Intelligenz / AGI
Agenten und Werkzeugnutzung
Multimodale Eingaben
Recherche/Retrieval
Konversation
Veröffentlichte und nicht veröffentlichte Läufe
Wir zeigen 5 von 16 verifizierten Läufen dieser Aufgabe — von 5 der 6 getesteten Modelle.Nicht veröffentlicht: Phi-4-mini-instruct (1 Lauf; Prüfergebnisse zurückgezogen).Quelle: die Auswahl-Angaben der veröffentlichten Läufe. Sie zählen die Aufgabe über alle Varianten und kennen nur Modelle, von denen mindestens ein Lauf veröffentlicht ist.
Auswahl
Kuratierter Import: 4 von 18 verifizierten v2-Läufen von Claude Haiku 4.5 sind veröffentlicht. Die Auswahl ist kein repräsentatives Gesamtergebnis; was für die übrigen Läufe des Modells aufgezeichnet ist, steht unten.Aufgezeichnete Prüfungen aller verifizierten v2-Läufe dieses Modells, je Aufgabe (über alle Varianten einer Aufgabe). Die Prüfungen unterscheiden sich je Aufgabe, die Aufgaben sind also nicht untereinander vergleichbar.
artifact-motion-001Animierte Hero (CSS-Motion)3 von 3 Format- und Vorhandenseinsprüfungen bestanden · 3 Läufe
frontend-dashboard-002Datenviz-Dashboard mit InsightsPrüfergebnisse zurückgezogen · 3 LäufeAufgabe dieses Laufs
artifact-generative-003Aurora/Mesh-Gradient-Art0 von 2 Formatprüfungen bestanden · 3 Läufe
artifact-brand-004Brand-Board0 von 2 Formatprüfungen bestanden · 3 Läufe