Archivierter Pilot · Veröffentlichte Läufe dieser Datenbank; Repo-Bundles und frühere Staging-Zählungen sind separate Bestände.
Archivierter Pilot · Läufe vom 17.07.2026 bis 01.10.2026
Prüfstand
Ein früher Pilot, heute Archiv. Wir haben Modellen einen Auftrag gegeben und zeigen, was sie daraus gebaut haben — als Screenshot, mit einfachen Prüfungen der Datei. Kein Funktionstest, keine Rangliste. Aktuelle Spitzenmodelle sind in diesem Pilot noch nicht vertreten.
- Läufe öffentlich
- 28
- Modelle · 6 Aufgaben
- 6
- mit Prüfung des Ergebnisses
- 6/28
- Bewertungen veröffentlicht
- 0/28
Was getestet wurde
Keines der aktuellen Spitzenmodelle von OpenAI, Anthropic, Google und SpaceXAI ist dabei.
Spitzenmodelle: was diese Anbieter selbst als ihre besten Modelle führen; Quellen gelesen am 04.10.2026.
28 veröffentlichte Läufe von 6 Modellen zu 6 Aufgaben. Laufdatum in UTC.
| Modell | Läufe | Aufgaben | Laufdatum | Aktuelles Spitzenmodell |
|---|---|---|---|---|
| Claude Haiku 4.5 | 4 | 4 | 17.07.2026 | nein |
| GPT-5.6 Sol | 4 | 4 | 17.07.2026 | nein |
| Claude Fable 5 | 6 | 6 | 18.07.2026 | nein |
| GPT-5.6 Luna | 6 | 6 | 18.07.2026 | nein |
| Phi-4-mini-instruct | 3 | 2 | 30.08.2026, 01.10.2026 | nein |
| Qwen3.8-27B | 5 | 5 | 03.09.2026 | nein |
Gefüllter Punkt: Lauf mit mindestens einer Prüfung des Ergebnisses. Leerer Punkt: Lauf ohne.
Aurora/Mesh-Gradient-Art
artifact-generative-003-bA · Claude Fable 5 · Modell + HarnessB · GPT-5.6 Luna · Modell + Harness
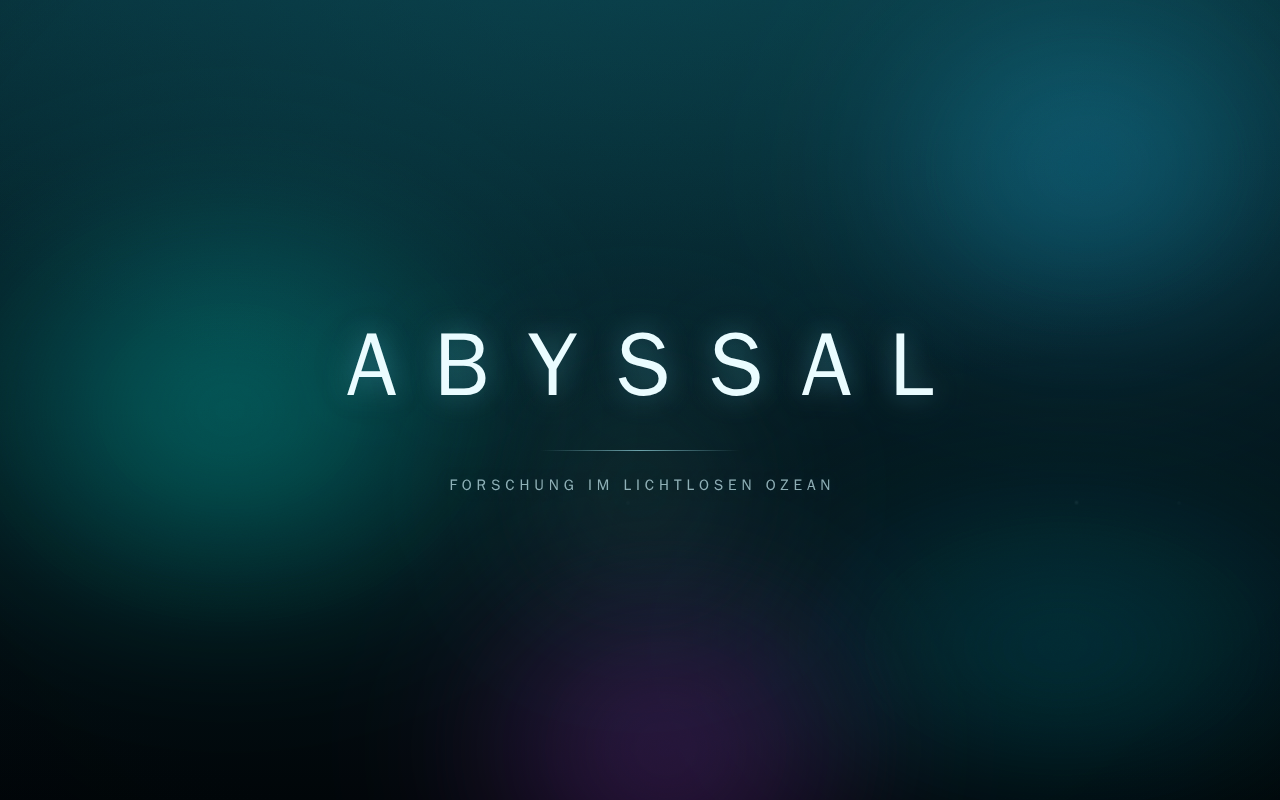
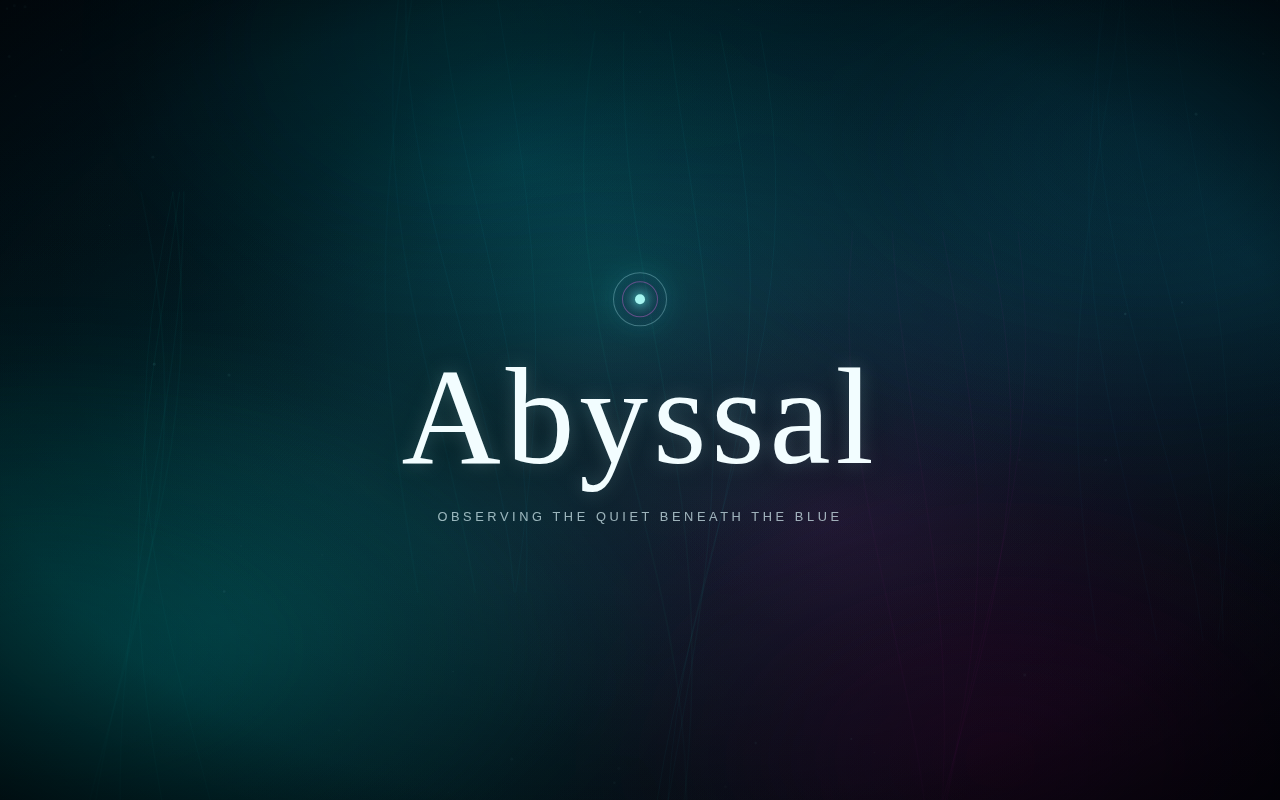 A · Claude Fable 5 · Modell + HarnessB · GPT-5.6 Luna · Modell + Harness
Screenshots: Wir rendern die gespeicherte, vom Modell erzeugte Datei offline. Die Datei selbst wird nicht ausgeliefert. Der Vergleich zeigt den oberen Ausschnitt eines Standbilds je Lauf.
Alle Ergebnisse · Aurora/Mesh-Gradient-Art
5 Läufe von 4 Modellen zum selben Auftrag. A und B holen einen Screenshot in den Vergleich. Läufe vom 18.07.2026 bis 01.10.2026.
Wir zeigen 4 von 15 verifizierten Läufen dieser Aufgabe — von 4 der 6 getesteten Modelle.Nicht veröffentlicht: Claude Haiku 4.5 (3 Läufe; 0 von 2 Formatprüfungen bestanden); GPT-5.6 Sol (3 Läufe; 0 von 2 Formatprüfungen bestanden).Dazu kommt 1 veröffentlichter Lauf ohne Auswahl-Angabe (nicht Teil des v2-Imports).Quelle: die Auswahl-Angaben der veröffentlichten Läufe. Sie zählen die Aufgabe über alle Varianten und kennen nur Modelle, von denen mindestens ein Lauf veröffentlicht ist.
- Claude Fable 5Claude Fable 5Format: 2 von 2 Prüfungen bestanden · Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenclaude-code-cli · Modell + Harness18.07.2026Lauf öffnen →
- GPT-5.6 LunaGPT-5.6 LunaFormat: 2 von 2 Prüfungen bestanden · Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufencodex-cli · Modell + Harness18.07.2026Lauf öffnen →
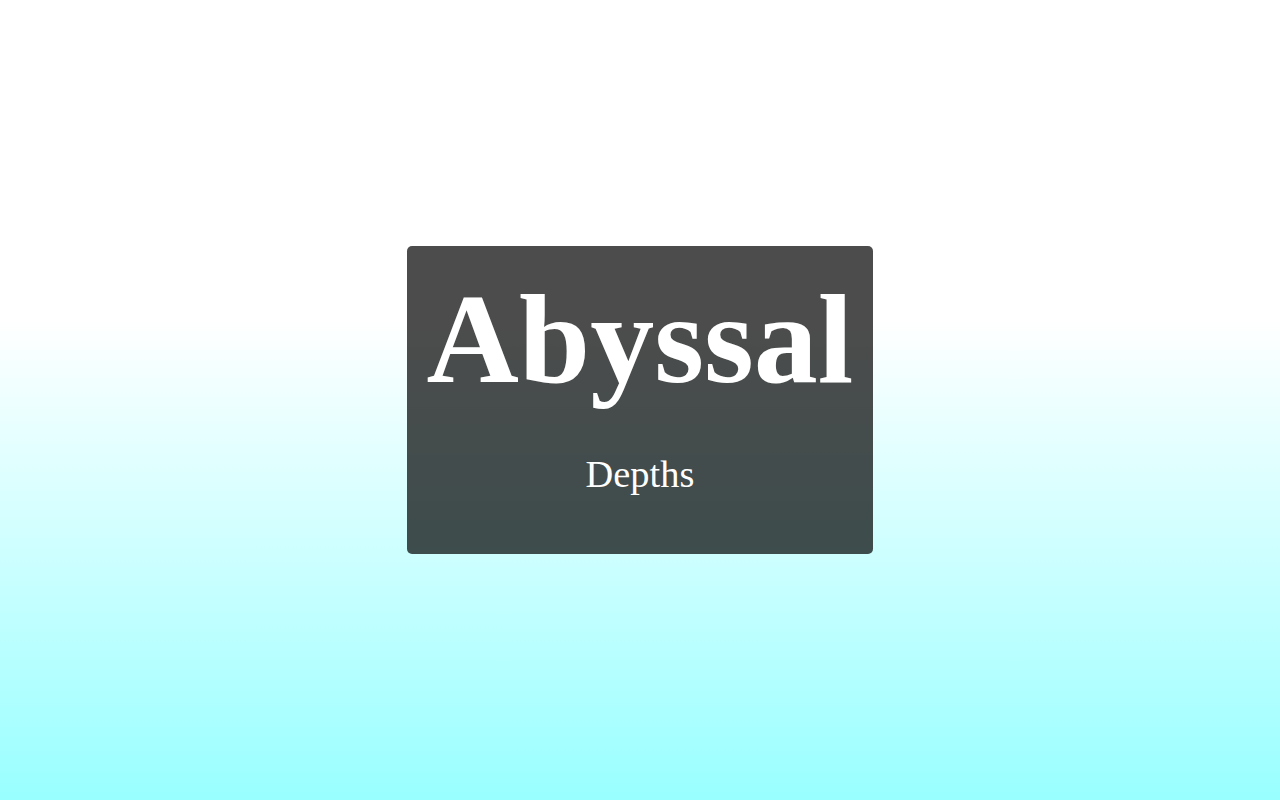 Phi-4-mini-instructPhi-4-mini-instructFormat: 1 von 2 Prüfungen bestanden · 1 von 2 Formatprüfungen bestanden — das Ergebnis selbst wurde nicht geprüft · 2 ohne erfasstes Ergebnisollama · nur Modell01.10.2026 · Token-Limit 8192Lauf öffnen →
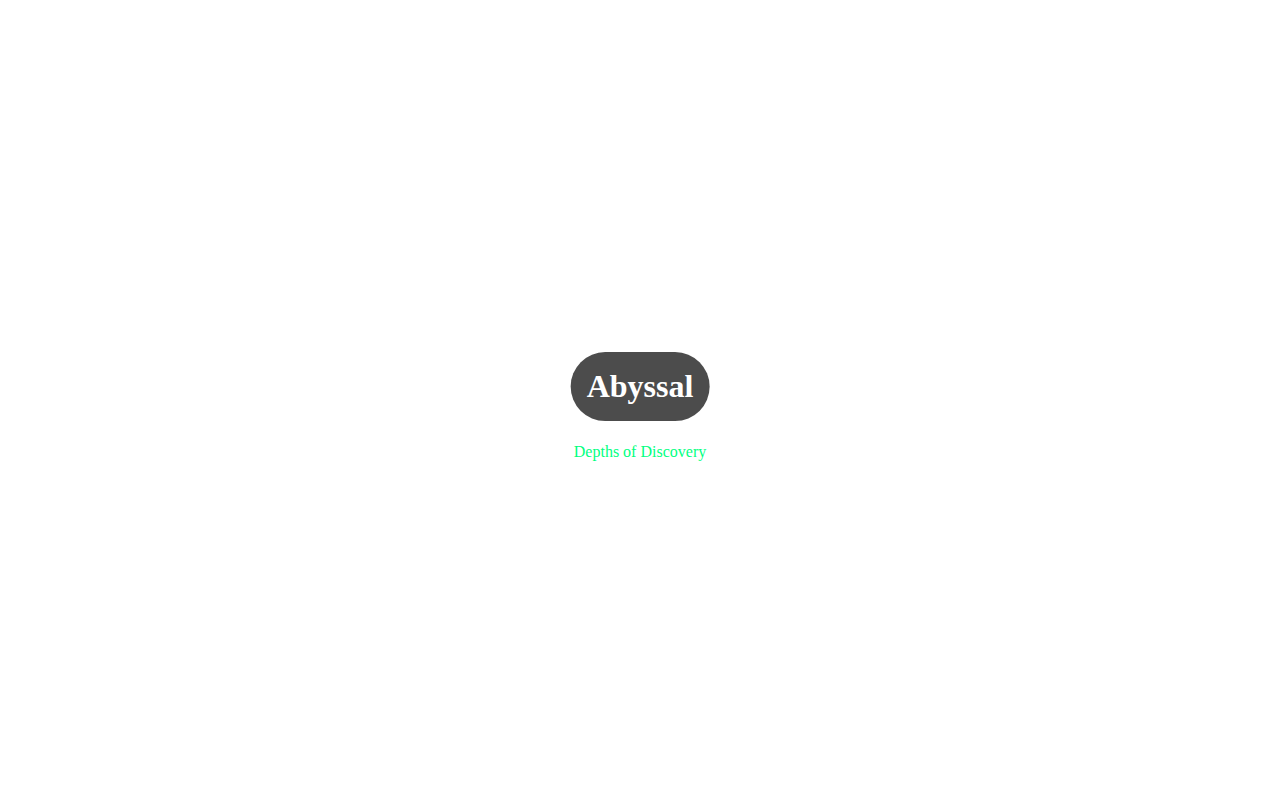 Phi-4-mini-instructPhi-4-mini-instructFormat: 1 von 2 Prüfungen bestanden · 1 von 2 Formatprüfungen bestanden — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenollama · nur Modell30.08.2026 · Token-Limit 16000Lauf öffnen →
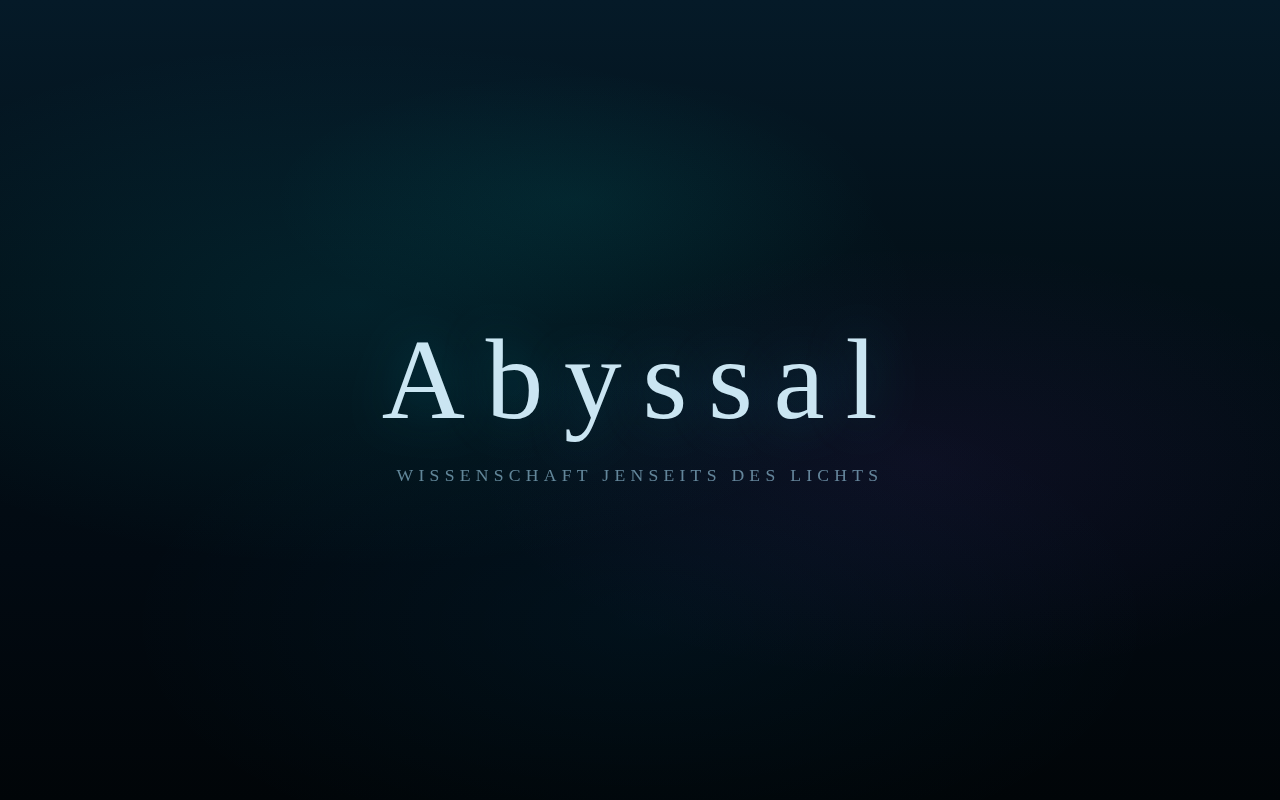 Qwen3.8-27BQwen3.8-27BFormat: 2 von 2 Prüfungen bestanden · Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufenollama · nur Modell03.09.2026Lauf öffnen →
Läufe derselben Aufgabe sind nicht automatisch gleich getestet: Laufzeit, Token-Limit und Protokoll können sich unterscheiden. Jeder Lauf nennt seine eigenen.