Claude Fable 5
über claude-code-cli 2.1.214Modell + Harness
Lauf vom 18.07.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
Archivierter Pilot · Historischer Run
gebaut von GPT-5.6 Luna über codex-cli 0.144.5 Modell + Harness
Von agi.jetzt aus dem vom Modell erzeugten Artefakt gerendertOffline in einem isolierten Renderer aus der gespeicherten Datei gerendert (sha256 c791e011908a…). Die Datei selbst wird nicht ausgeliefert.
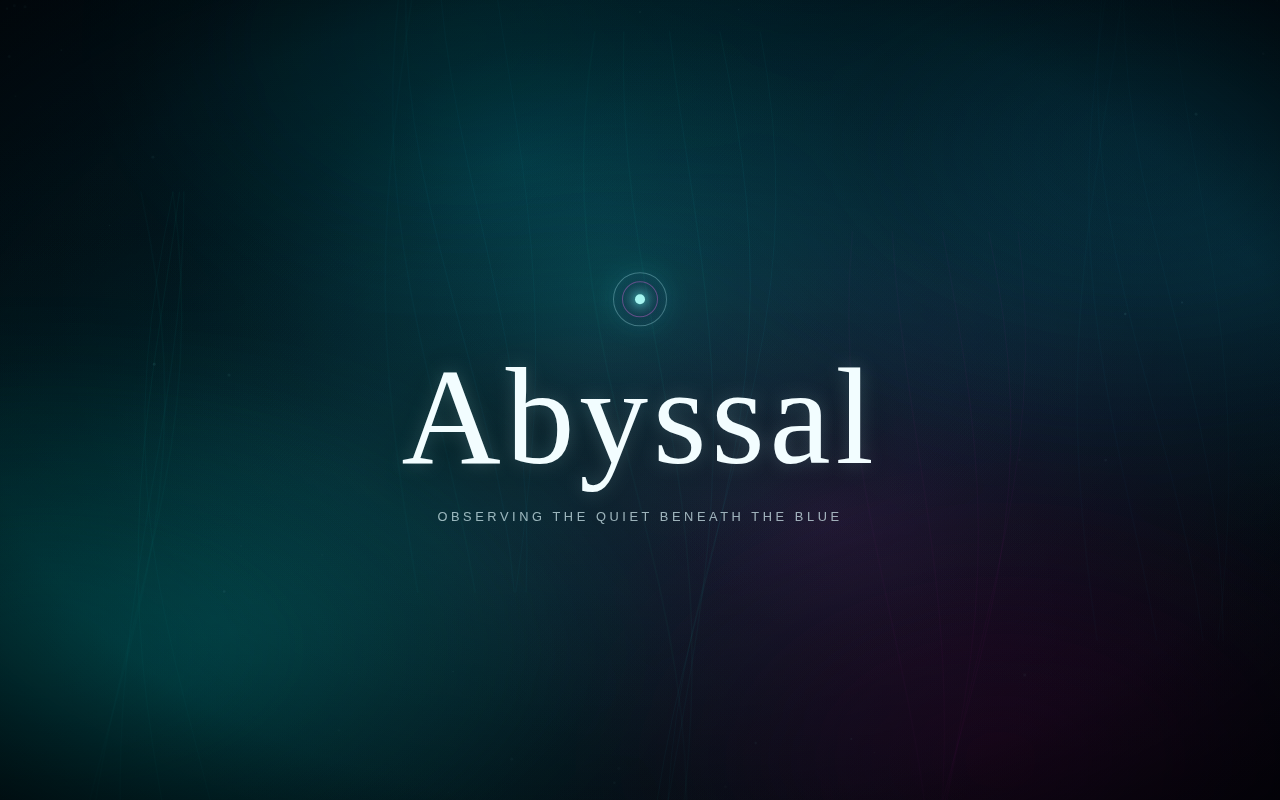
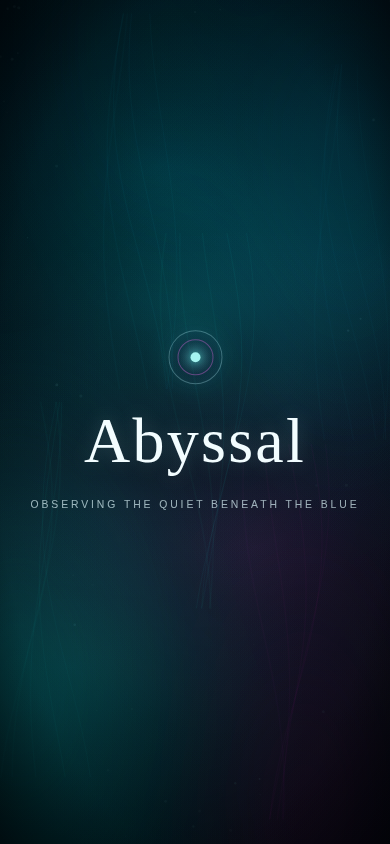
Seitlich scrollen. Jeder Lauf hatte eigene Laufzeit und Limits — vergleichen Sie die Artefakte, nicht einen Score.
über claude-code-cli 2.1.214Modell + Harness
Lauf vom 18.07.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
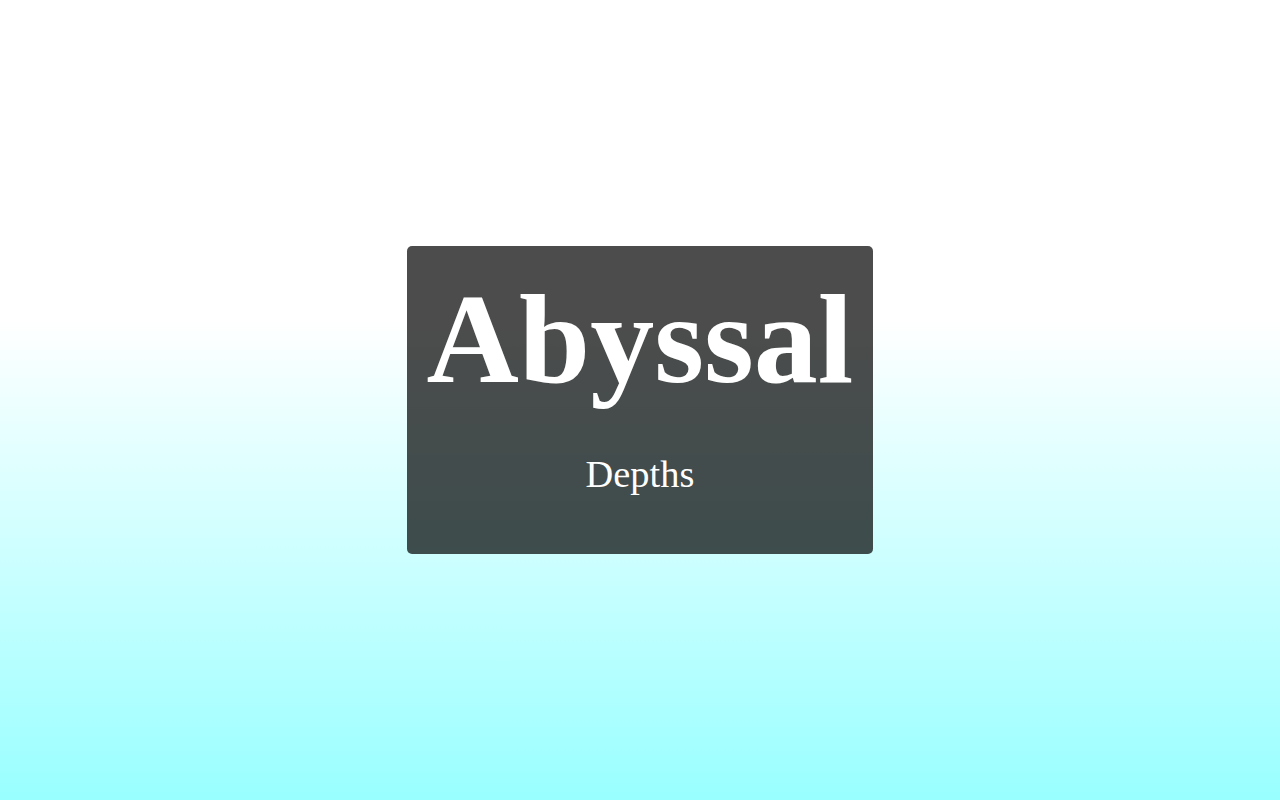
über ollama 0.32.15nur Modell
Lauf vom 01.10.2026Token-Limit 8192
1 von 2 Formatprüfungen bestanden — das Ergebnis selbst wurde nicht geprüft
2 ohne erfasstes Ergebnis
Bewertung nicht veröffentlicht
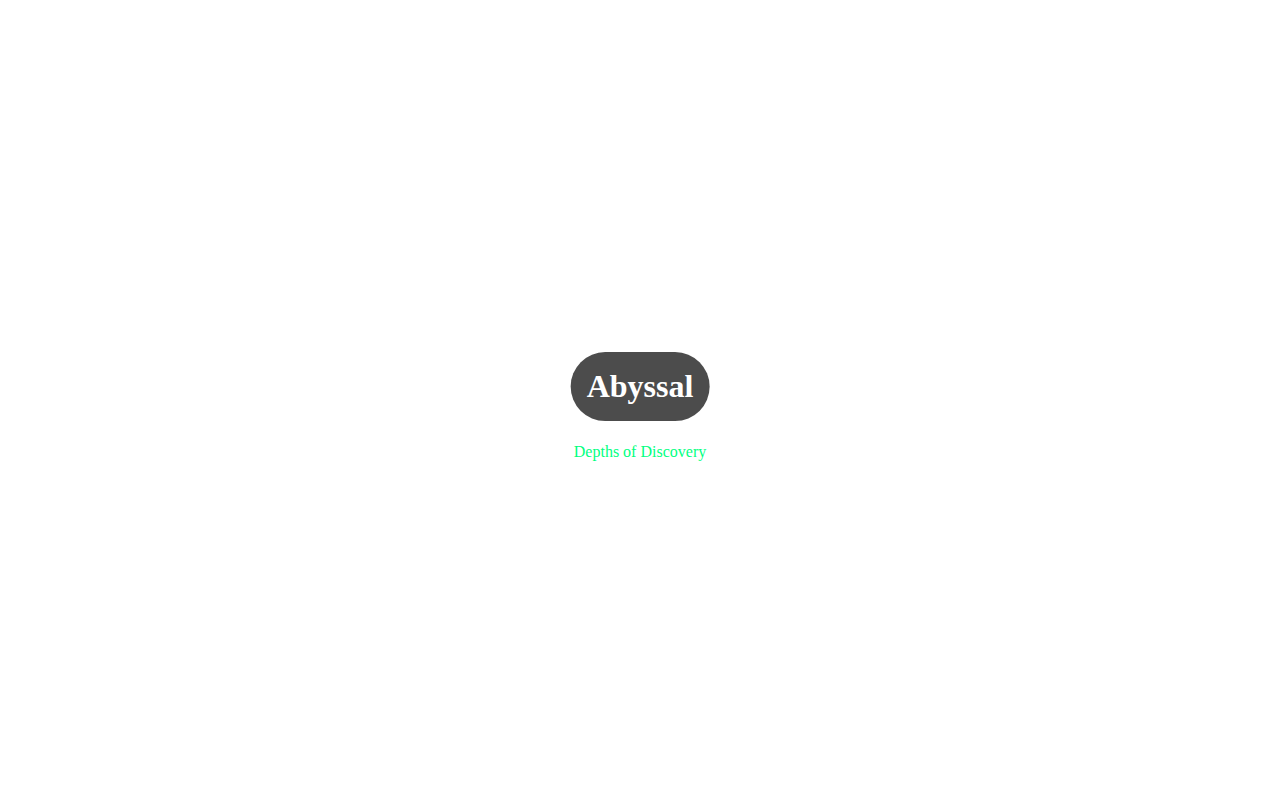
über ollama 0.32.15nur Modell
Lauf vom 30.08.2026Token-Limit 16000
1 von 2 Formatprüfungen bestanden — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
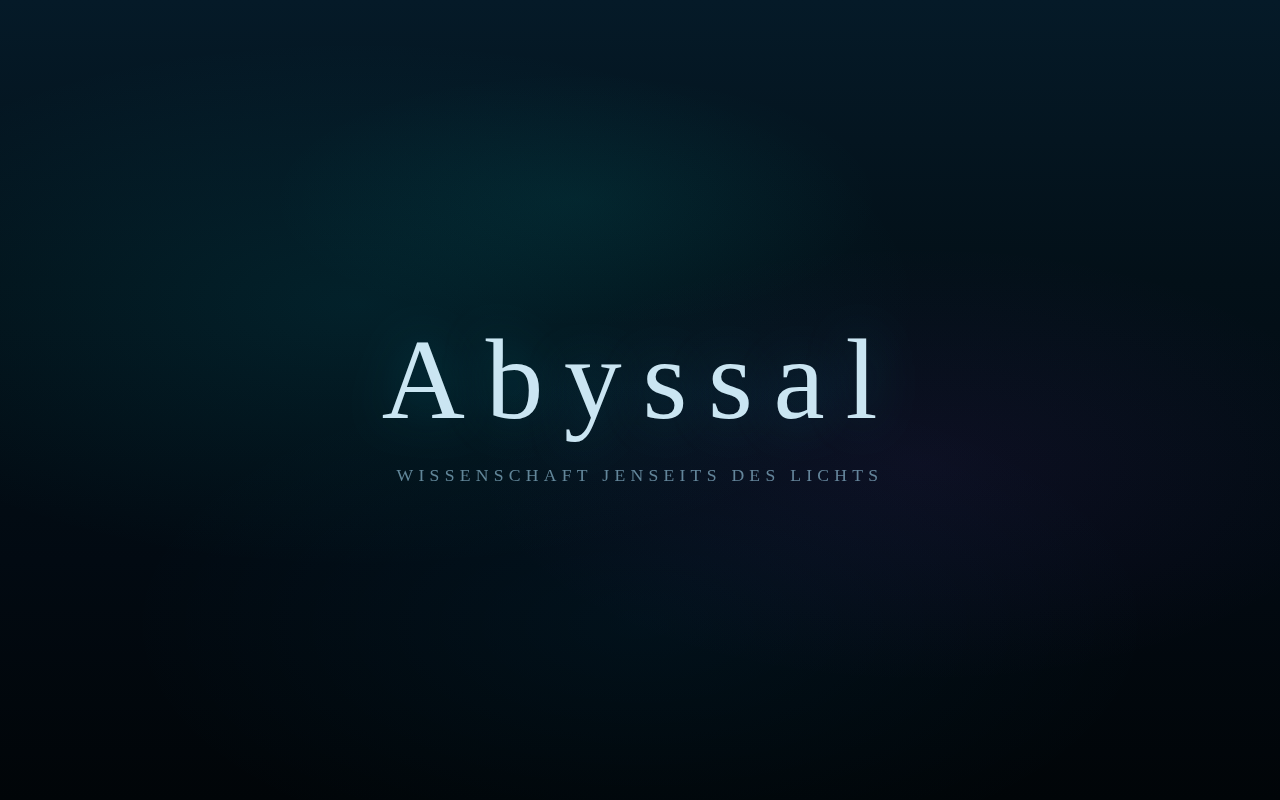
über ollama 0.32.15nur Modell
Lauf vom 03.09.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
Automatische Prüfungen an der gespeicherten HTML-Datei, ohne sie im Browser auszuführen. Prüfungen von Format und Vorhandensein sagen nichts darüber, ob das Ergebnis den Auftrag erfüllt.
| Prüfung | Art | Ergebnis |
|---|---|---|
| single_html5_filegenau eine HTML5-Datei | Format | Bestanden |
| viewport_metaViewport-Meta: 1 (erwartet 1) | Format | Bestanden |
| no_external_requestsSandbox nicht verfügbar — Rendering übersprungen | Rendering | nicht ausgeführt |
| renders_without_console_errorsSandbox nicht verfügbar — Rendering übersprungen | Rendering | nicht ausgeführt |
2 Prüfungen im Browser sind nicht gelaufen. Grund laut Protokoll: „Sandbox nicht verfügbar — Rendering übersprungen“.
WarumDer v2-Eintrag des Bewertungsmodells nennt das getestete Modell als sein eigenes Bewertungsmodell und enthält keine Kriterien. Sein Wert wird deshalb nicht gezeigt — ebenso wenig der kombinierte v2-Wert, in den er einfließt.
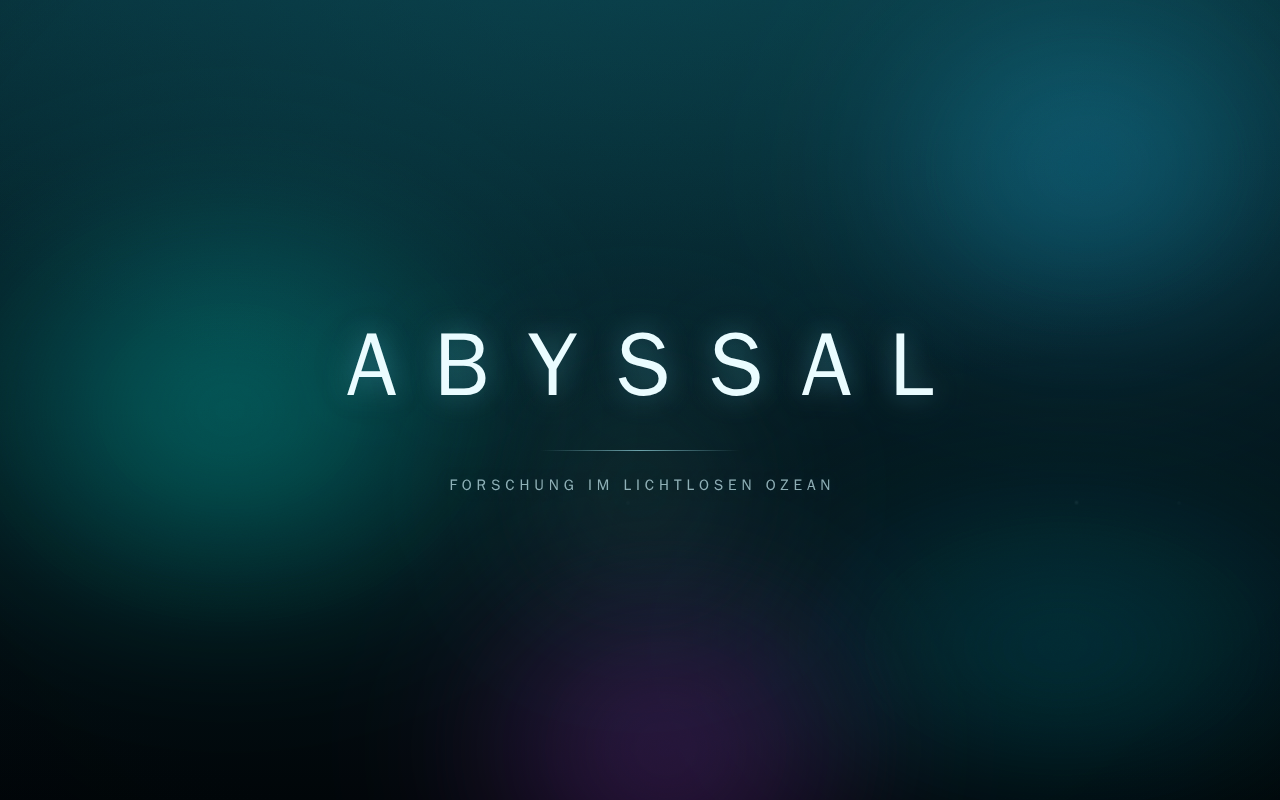
Baue als EINE einzelne HTML-Datei (kein Framework, kein externes Asset, keine externen Fonts) einen bildschirmfüllenden, animierten Hintergrund im Stil Biolumineszenz in der Tiefe: tiefes Petrol bis Schwarz, darüber schwebende, leuchtende Schlieren in Türkis, Cyan und einem kalten Magenta, die sich träge wie Quallen bewegen. Geheimnisvoll, ruhig, kühl. Helle, klare Wortmarke. für die Startseite eines Tiefsee-Forschungsprojekts.
Anforderungen:
- Ein atmosphärischer, animierter Verlauf (Aurora / Mesh-Gradient / fließende Farbwolken), der den gesamten Viewport füllt und sich langsam, organisch bewegt — via CSS-Animation oder Canvas, selbst erzeugt.
- Ruhige, hochwertige Bewegung mit weichem Easing; die Farben durchmischen sich stimmig, kein hartes Flackern, keine sichtbaren Kanten oder Banding-Streifen.
- Darüber eine knappe, zentrierte Bildmarke: „Abyssal" als elegante Wortmarke plus eine kurze, ruhige Zeile darunter — gut lesbar über dem bewegten Grund.
- `@media (prefers-reduced-motion: reduce)`: Bewegung anhalten, ein ebenso schöner statischer Verlauf bleibt.
- Bildschirmfüllend ohne Scrollbalken, kein horizontaler Overflow.Aus dem Aufgaben-Seed; die tatsächlichen Prompts ergänzen Ausgabeformat-Anweisungen und andere Formulierungen.
Modell Die Modellkennung des Testprogramms entspricht GPT-5.6 Luna in unserer Modellliste (verifizierte Zuordnung).
Kein AGI-MaßDieser Lauf zeigt genau eines: was ein Modell aus einem präzisen Brief als einzelne HTML-Datei gebaut hat. Über allgemeine Intelligenz sagt er nichts.In diesem Lauf automatisch geprüft: Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufen.
Wir zeigen 4 von 15 verifizierten Läufen dieser Aufgabe — von 4 der 6 getesteten Modelle.Nicht veröffentlicht: Claude Haiku 4.5 (3 Läufe; 0 von 2 Formatprüfungen bestanden); GPT-5.6 Sol (3 Läufe; 0 von 2 Formatprüfungen bestanden).Dazu kommt 1 veröffentlichter Lauf ohne Auswahl-Angabe (nicht Teil des v2-Imports).Quelle: die Auswahl-Angaben der veröffentlichten Läufe. Sie zählen die Aufgabe über alle Varianten und kennen nur Modelle, von denen mindestens ein Lauf veröffentlicht ist.