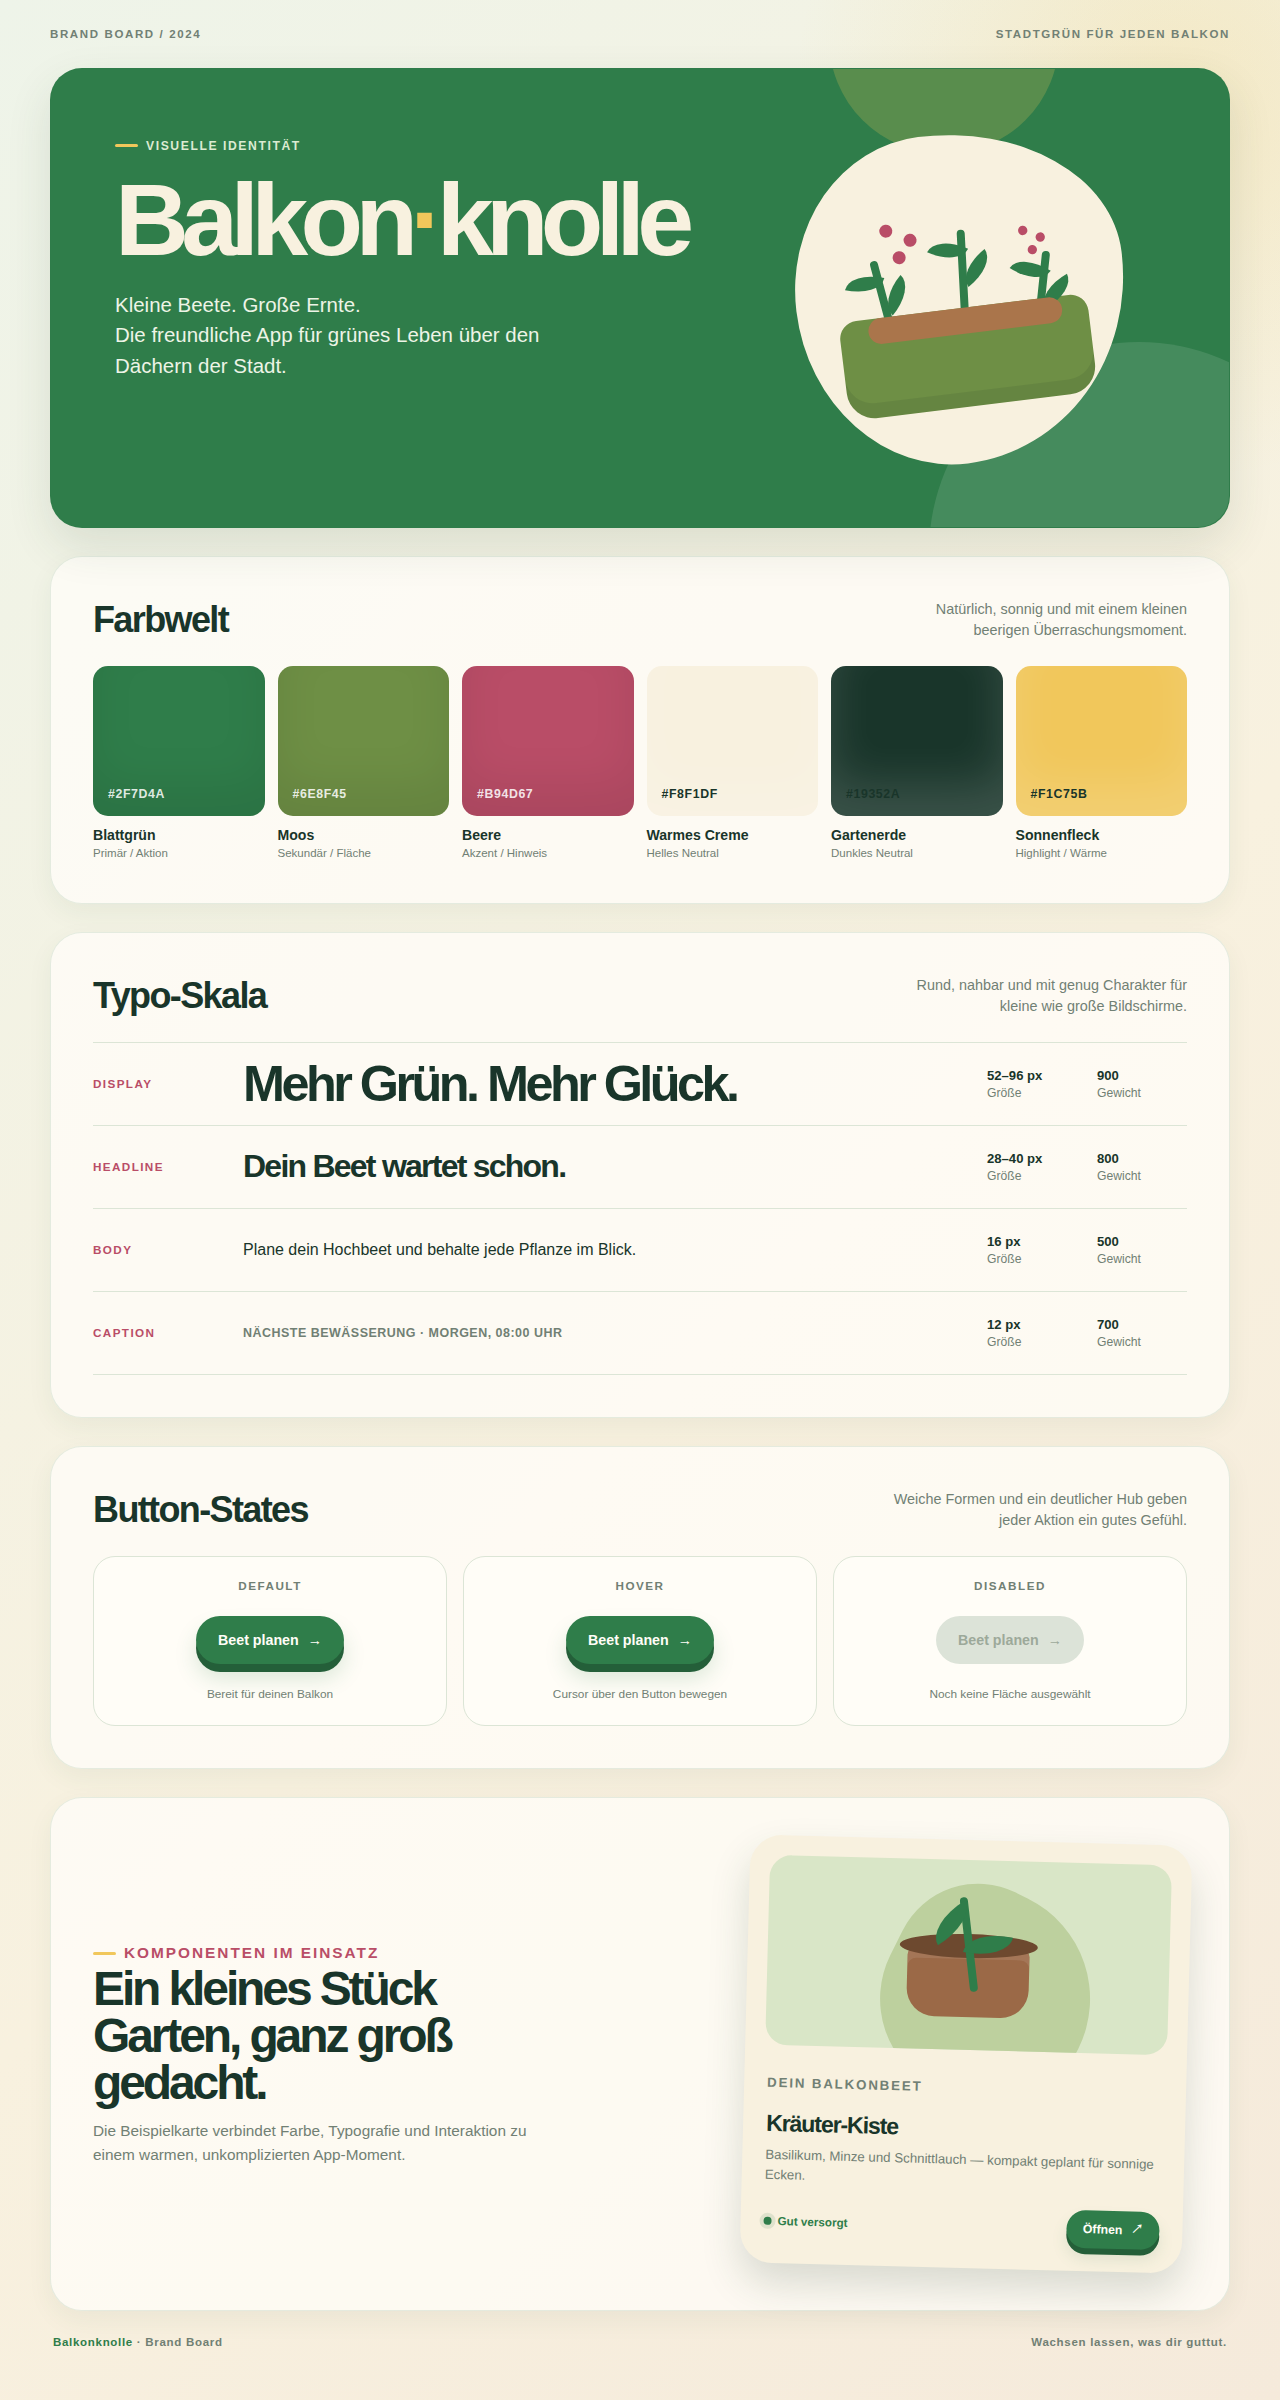
GPT-5.6 Luna
über codex-cli 0.144.5Modell + Harness
Lauf vom 18.07.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
Archivierter Pilot · Historischer Run
gebaut von Claude Fable 5 über claude-code-cli 2.1.214 Modell + Harness
Von agi.jetzt aus dem vom Modell erzeugten Artefakt gerendertOffline in einem isolierten Renderer aus der gespeicherten Datei gerendert (sha256 653ae33a54c0…). Die Datei selbst wird nicht ausgeliefert.
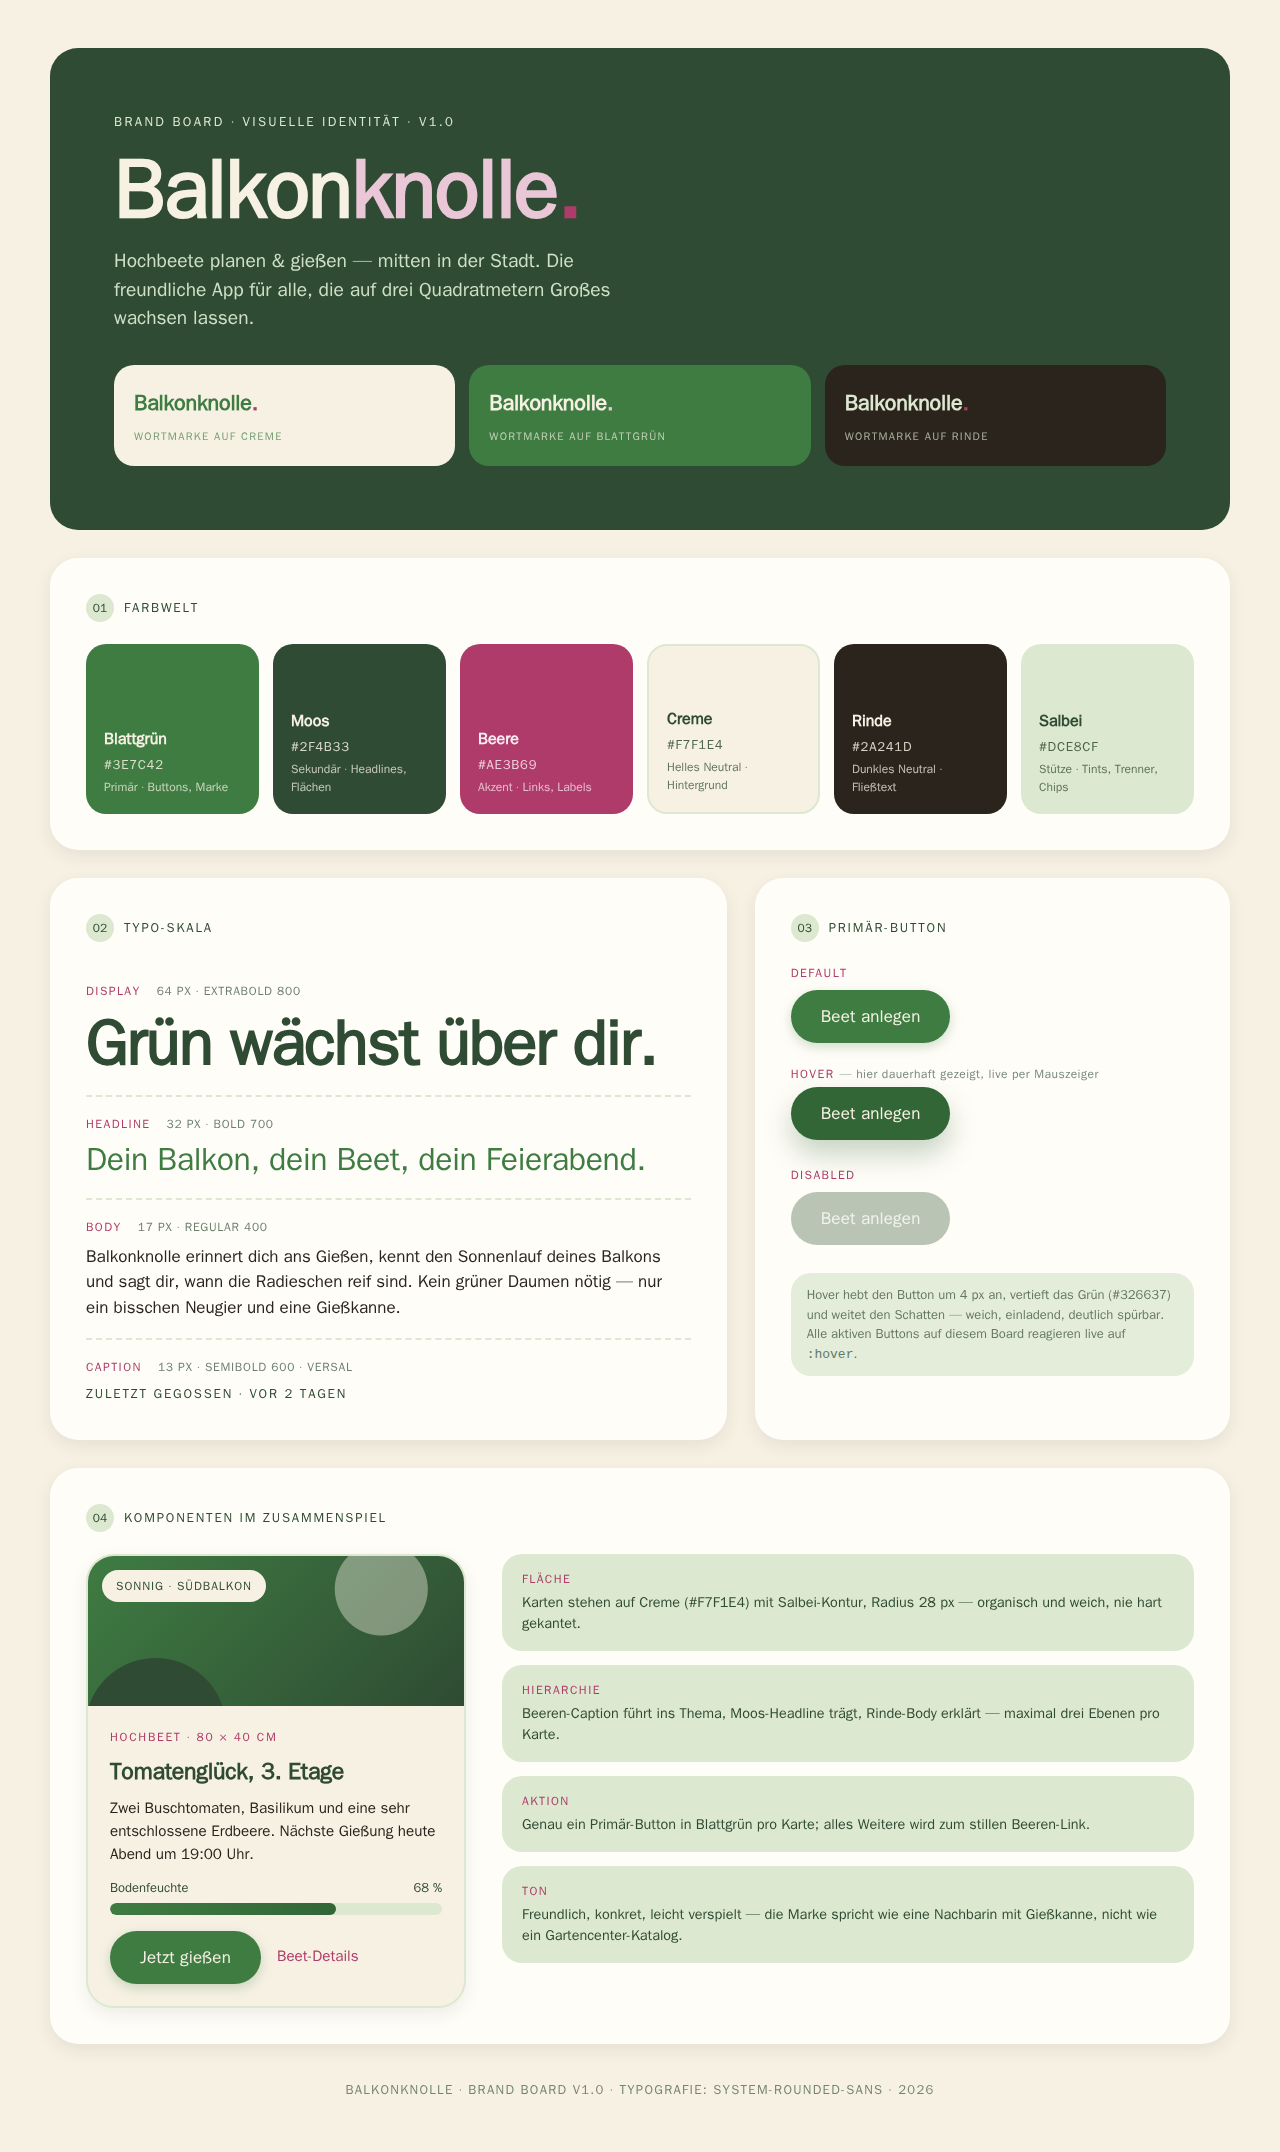

Seitlich scrollen. Jeder Lauf hatte eigene Laufzeit und Limits — vergleichen Sie die Artefakte, nicht einen Score.
über codex-cli 0.144.5Modell + Harness
Lauf vom 18.07.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
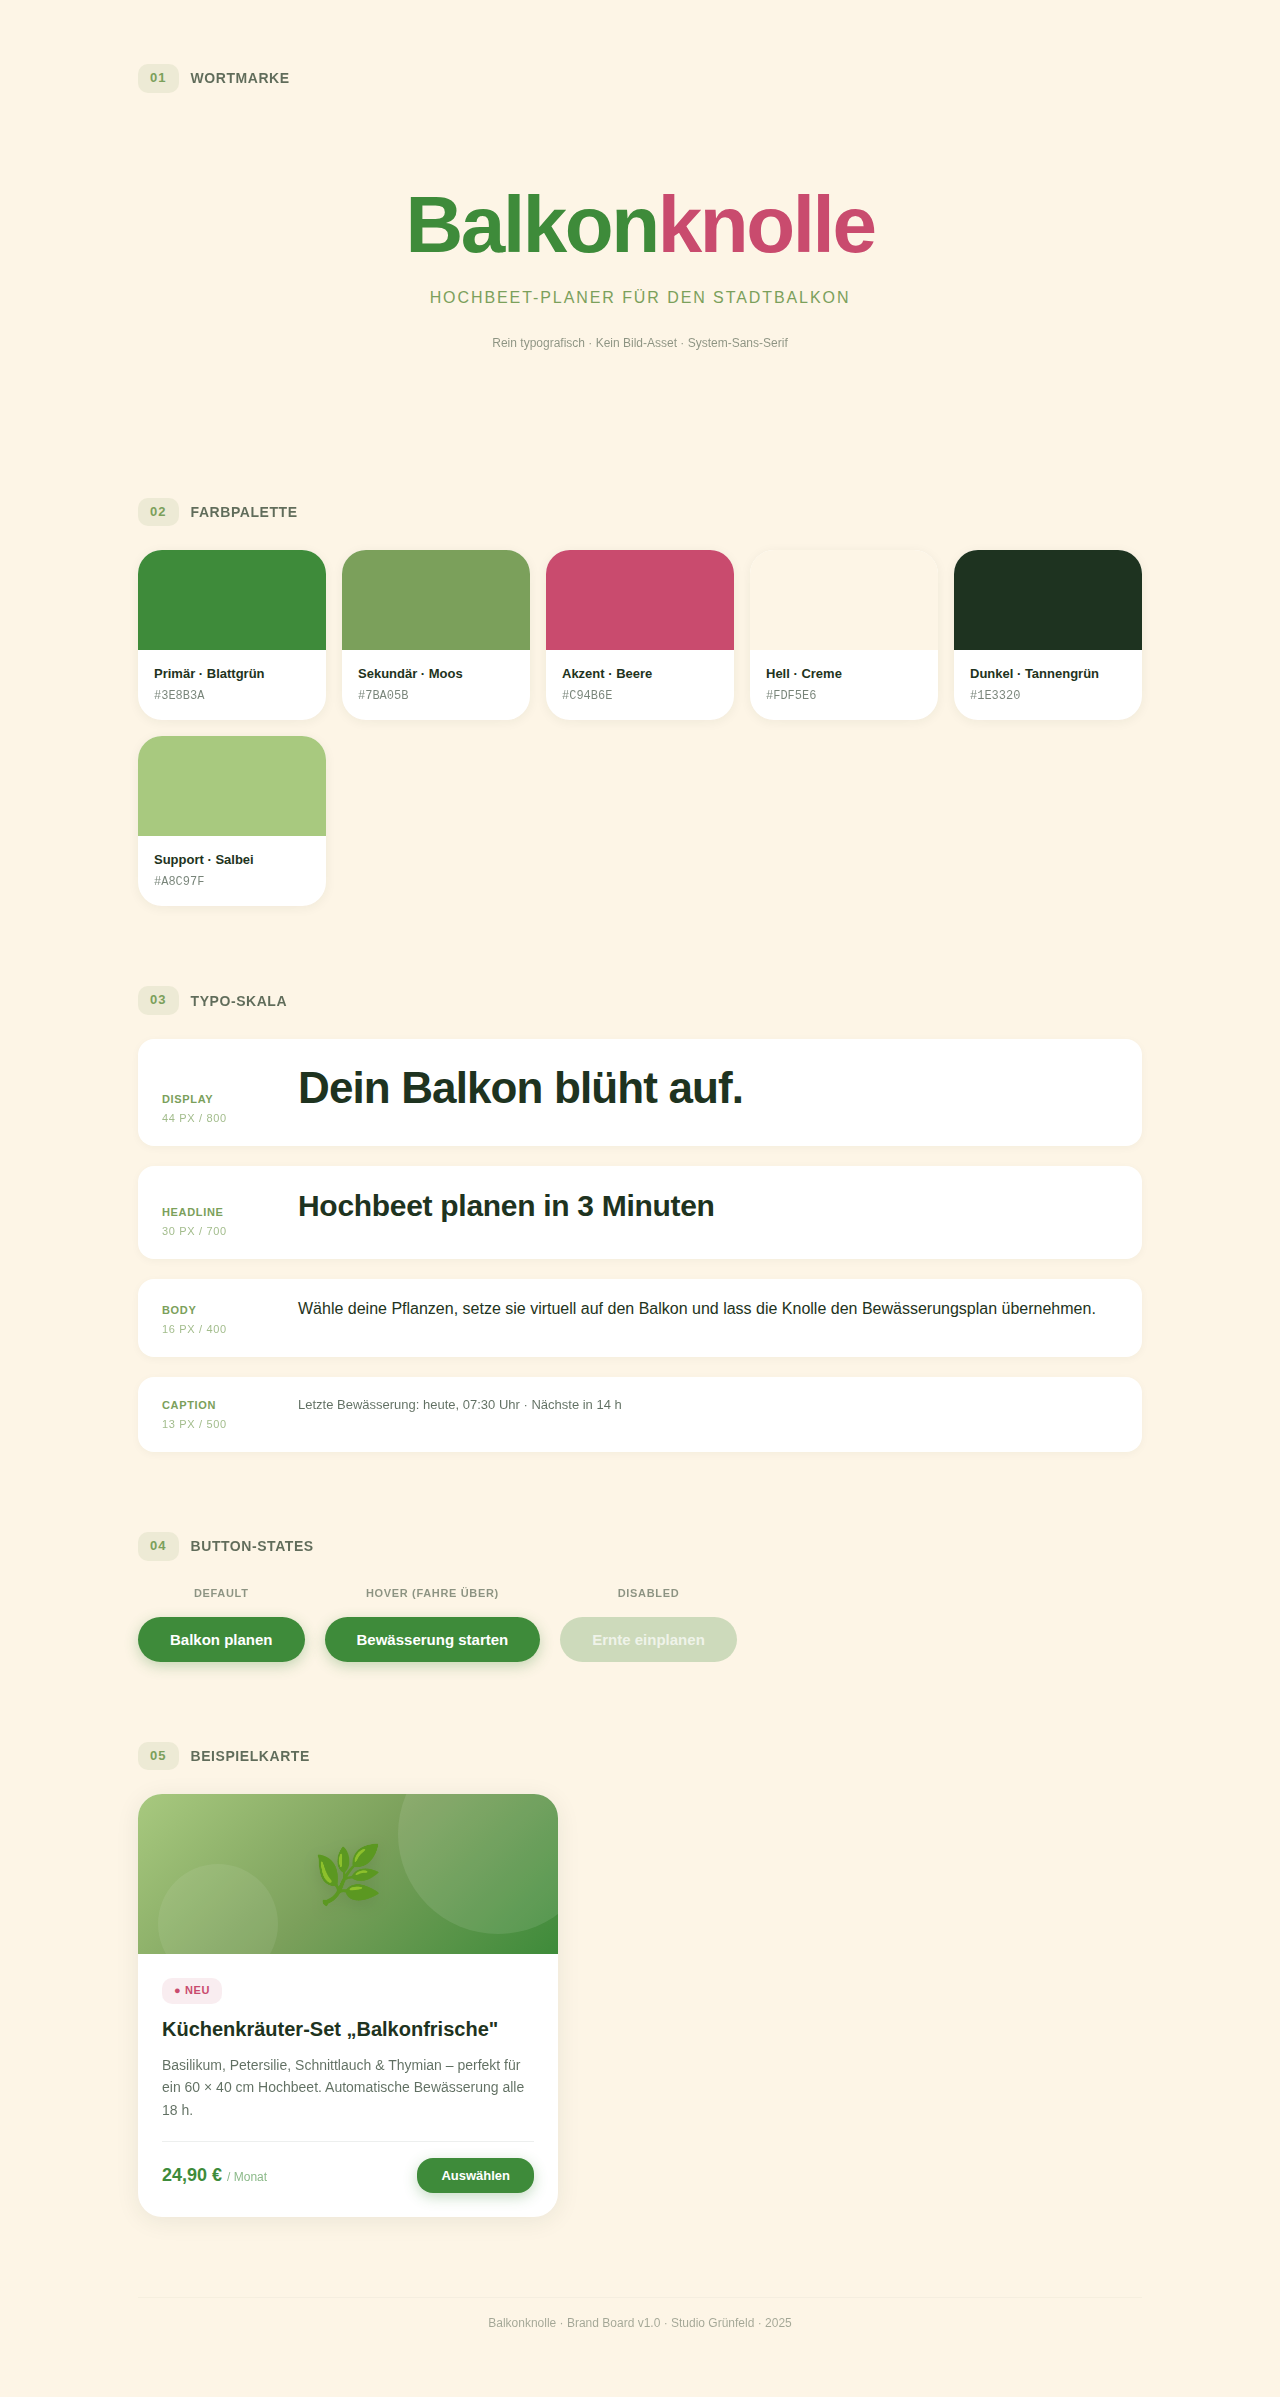
über ollama 0.32.15nur Modell
Lauf vom 03.09.2026
Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft
2 Prüfungen im Browser nicht gelaufen
Bewertung nicht veröffentlicht
Automatische Prüfungen an der gespeicherten HTML-Datei, ohne sie im Browser auszuführen. Prüfungen von Format und Vorhandensein sagen nichts darüber, ob das Ergebnis den Auftrag erfüllt.
| Prüfung | Art | Ergebnis |
|---|---|---|
| single_html5_filegenau eine HTML5-Datei | Format | Bestanden |
| viewport_metaViewport-Meta: 1 (erwartet 1) | Format | Bestanden |
| no_external_requestsSandbox nicht verfügbar — Rendering übersprungen | Rendering | nicht ausgeführt |
| renders_without_console_errorsSandbox nicht verfügbar — Rendering übersprungen | Rendering | nicht ausgeführt |
2 Prüfungen im Browser sind nicht gelaufen. Grund laut Protokoll: „Sandbox nicht verfügbar — Rendering übersprungen“.
WarumDer v2-Eintrag des Bewertungsmodells nennt das getestete Modell als sein eigenes Bewertungsmodell und enthält keine Kriterien. Sein Wert wird deshalb nicht gezeigt — ebenso wenig der kombinierte v2-Wert, in den er einfließt.
Baue als EINE einzelne HTML-Datei (kein Framework, kein externes Asset, keine externen Fonts) ein vollständiges Brand-Board für Balkonknolle — eine App, mit der Stadtbewohner Hochbeete auf dem Balkon planen und bewässern.
Das Board präsentiert die visuelle Identität übersichtlich auf einer Seite und enthält:
- Die Wortmarke / das Logo, rein typografisch gesetzt (kein Bild-Asset), prominent platziert.
- Eine Farbpalette: mindestens 5 Farbfelder (z. B. Primär, Sekundär, Akzent, helles und dunkles Neutral) — jedes mit sichtbarem Hex-Wert und Rollennamen.
- Eine Typo-Skala: mindestens Display, Headline, Body und Caption mit Beispieltext, Schriftgröße und Schriftgewicht.
- Button-States: mindestens Default, Hover und Disabled eines Primär-Buttons (Hover über :hover tatsächlich sichtbar).
- Eine Beispielkarte (z. B. Produkt- oder Info-Karte), die Farben, Typo und Button im Zusammenspiel zeigt.
Stilvorgabe: Freundlich und organisch: satte Grüntöne (Blattgrün, Moos) mit warmem Creme und einem Beeren-Akzent, abgerundete Formen, große Radien, verspielte aber aufgeräumte Sans-Serif. Buttons weich und einladend mit deutlichem Hover-Hub.
Sauber gerastert, klar beschriftet, wie eine echte Marken-Übersichtsseite eines Studios. Responsive, kein horizontaler Overflow.Aus dem Aufgaben-Seed; die tatsächlichen Prompts ergänzen Ausgabeformat-Anweisungen und andere Formulierungen.
Modell Die Modellkennung des Testprogramms entspricht Claude Fable 5 in unserer Modellliste (verifizierte Zuordnung).
Kein AGI-MaßDieser Lauf zeigt genau eines: was ein Modell aus einem präzisen Brief als einzelne HTML-Datei gebaut hat. Über allgemeine Intelligenz sagt er nichts.In diesem Lauf automatisch geprüft: Format stimmt (2 von 2) — das Ergebnis selbst wurde nicht geprüft · 2 Prüfungen im Browser nicht gelaufen.
Wir zeigen 3 von 13 verifizierten Läufen dieser Aufgabe — von 3 der 5 getesteten Modelle.Nicht veröffentlicht: Claude Haiku 4.5 (3 Läufe; 0 von 2 Formatprüfungen bestanden); GPT-5.6 Sol (3 Läufe; 0 von 2 Formatprüfungen bestanden).Quelle: die Auswahl-Angaben der veröffentlichten Läufe. Sie zählen die Aufgabe über alle Varianten und kennen nur Modelle, von denen mindestens ein Lauf veröffentlicht ist.